


AI大模型开发入门 Python 重点笔记
- 1AI大模型开发入门 Python 重点笔记本文
重点复习:
- 基础语法中input输入、字符串格式化、运算符
- 逻辑判断:if、ifelse、if的嵌套
- 循环:for、while、嵌套(缩进)
- 函数:基础语法(函数多种传参、返回值的概念)
- 数据容器:列表(切片)、字符串(切片)、字典
- 切片非常常用,熟练掌握
- 数量掌握lambda语法
- 返回多个返回值(返回元组)
- 文件操作(打开、关闭、读取、写入)
- pip安装
方法:将以前的作业再来一遍
或询问AI,比如我想练习Python的循环,给我来10个
基础语法
字面量
概念:书写到代码内的,被固定下来的,值,就是字面量。
即:某些值是如何在代码里面写出来的。
值的类型:
Python中值类型很多,目前简单接触了解3个:
- 整型(Integer、int):整数的意思(包含负的)
- 浮点型(Float):浮点数的意思(有小数点的数字)(包含负的)
- 字符串、文本(String、str):文本类型
- 中文、英文、数字、符号等一堆字符的集合体,就是字符串
三种类型在代码中的书写方式:
# 整型321-123
# 浮点型32.11-11.23
# 字符串"黑马程序员666"整型、浮点型和日常生活中所见,基本一致
字符串(文本)需要以
""包围起来(Python语法要求,必须)
print也可以将字面量在屏幕中显示出来,如下代码:
print(666)print(12.34)print("黑马666")注释
概念:对代码的解释说明文本。注释本身不是代码(执行的时候会被自动删除),只在阅读的时候有用。
简单来说,有了注释,就可以对代码的内容做解释和说明。
分类:
- 单行注释:以
#开头,其所在行右侧全部内容作为注释存在- 一般建议
#和注释内容之间,相隔一个空格 - 示例:
# 我是注释
- 一般建议
- 多行注释:以
"""开头,以"""结尾,在其闭合区间内,全部内容作为注释存在- 注意:
""" """ """如果这样写,最后的"""是无用的,即闭合区间的匹配逻辑是就近匹配一堆"""
- 注意:
变量
概念:在程序运行的过程中,进行数据的存储,同时存储的数据也可以发生修改。
特点:
-
可以存储数据,且不限类型
-
存储的数据是可以修改的(变量的变字由来)
-
变量本身没有类型,但是存储的数据是有类型的,注意如下口头语:
字符串变量,表示一个存放了字符串数据的变量
-
可以被重复使用
name = "周杰轮"print(name)print(name)...# name变量可以任意重复利用
语法:
变量名 = 变量值;=是赋值语句,表示:右侧先执行得到结果,将结果赋予左侧的变量存储。
右侧先执行得到结果,将结果赋予左侧的变量存储。
右侧先执行得到结果,将结果赋予左侧的变量存储。
即:不论右侧如何写,反正右侧必须全部执行完毕得到结果,才会将结果赋予左侧变量。
print输出多份内容
print语句(函数)可以向屏幕内一次性输出多份内容,语法如下:
print(内容1, 内容2, ... ,..., 内容N)- 内容可以是:字面量、变量、表达式(会产生计算结果的)(比如5+3)
示例:
name = "大锤"print("你好我是", name, ",很高兴认识你")
# 结果: 你好我是 大锤 ,很高兴认识你数据类型
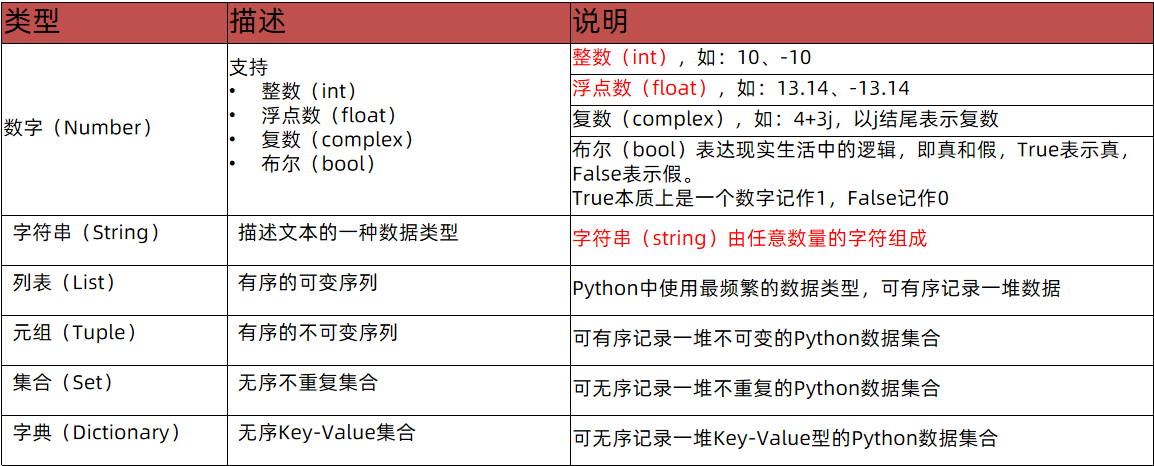
上图是Python较为完整的常见数据类型,我们目前仅仅接触三个:
- 整型(int、整数)
- 浮点型(float、小数)
- 字符串型(string、str、文本)
转换
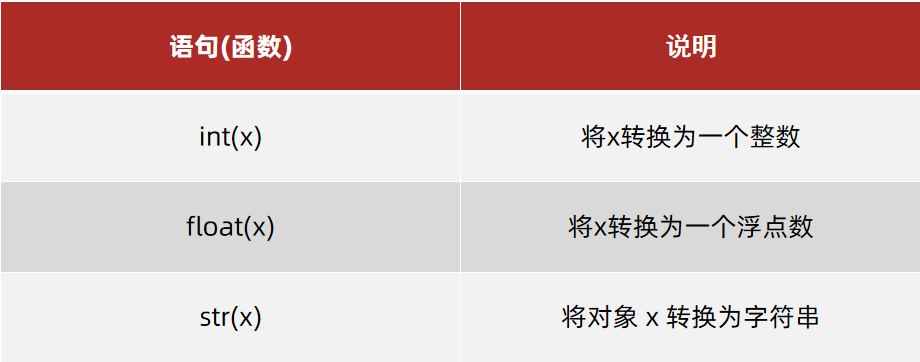
在转换的时候要注意:
- 任何类型都可以转换为字符串
- 字符串不一定能转换为数字,比如:
"123"可以转换为123"abc123"就无法转换为数字了- 即:要求字符串内部全部是数字才行
标识符
概念:标识符是编程语言中,对任何事物的命名,这个名字都叫做标识符
简单来说,标识符就是名字
规则(强制)
-
内容限定:只允许数字、下划线、中文、英文
- 数字不可以开头
- 中文不推荐(可以用,但不建议)
-
大小写敏感,变量
Age和变量age是2个不同的东西 -
关键字限定,不可以在起名的时候用Pyhton内置关键字
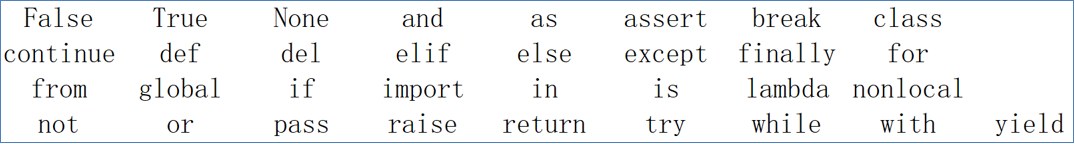
这些关键字:不要背
规范(建议)
- 见名知义
- 明了:名字要能体现变量的作用
- 简洁:尽量长度短一点
- 下划线命名:多个单词混在一起可以用下划线分开
- 字母全小写(仅用于变量):变量名用的英文字母,全部小写
运算符
算术运算符
做数学运算的。
+加法-减法*乘法/除法(非整除)//整除%取余(取模)**求指数(平方)
赋值运算符
=将右侧结果赋予左侧变量- 复合赋值:
a?=b相当于:a = a?b,这个?可以是任何的算术运算符
字符串
三种定义模式
- 单引号写法:
'黑马' - 双引号写法:
"黑马" - 三引号写法:
"""黑马"""- 这个写法,没有变量接收,则就是多行注释
- 如果用变量接收,就是字符串
加法拼接字符串
Python提供的+ 号,在进行字符串相加的时候,是完成字符串的首尾拼接
如下:
info = "黑马" + "程序员"print(info)# 运行结果:黑马程序员注意:+拼接只用于字符串和字符串,如果用于其它类型,需要转换
比如:
可以看到拼接age的时候,用了str()做类型转换
字符串格式化(%占位符形式)
语法:
"%s %d %f ... ..." % (变量, 变量, 变量, ....,...)%s表示以字符串形式占位,等到数据的填充%d表示以整数形式占位,等到数据的填充%f表示以浮点数形式占位,等到数据的填充- %占位符的数量要和后续提供填充的数据的数量是一比一
- 任意数据类型可以用%s占位,但是不是任意类型都可以用%d或%f占位,要注意数据的转换关系
- 如:%f占位,提供的数据是”abc”肯定是不可以的
示例:
name = "周杰轮"print("你是:%s" % name)# 结果是: 你是 周杰轮
age = 11height = 172.55print("你是%s,身高:%f,年龄:%d" % (name, height, age))# 结果:你是周杰轮,身高:172.550000,年龄:11默认的%f占位,浮点数会使用6位小数精度,没有的话会补充0
字符串格式化(f_format、f_string形式)
语法:
f"{变量、常量、表达式}......"示例:
name = "周杰轮"age = 11height = 172.55print(f"你是{name},身高:{height},年龄:{age}")# 结果:你是周杰轮,身高:172.55,年龄:11字符串格式化的数字精度
基础写法是:
%md%m.nfm表示数字的宽度.n表示小数点的宽度- 仅对浮点数有效
示例:
age = 11print("%5d" % age) # 结果: 11 11前面还有3个空格补充到5的宽度print(f"{age:5d}") # 结果: 11 11前面还有3个空格补充到5的宽度
height = 172.55print("%7.1f" % height) # 结果: 172.6 前面有2个空格 小数点精确1位(有四舍五入效果)print(f"{height:7.2f}") # 结果: 172.6 前面有2个空格 小数点精确1位(有四舍五入效果)表达式
概念:能够产出明确结果的代码语句,称之为表达式。
示例,如下都是表达式:
5+32*3+5/2type(1)age * 10 # age是一个变量input("请输入:")5>2input输入
概念:获取用户的键盘录入数据
语法:
name = input() # 从键盘输入内容,赋值给name变量
name = input("请输入姓名:") # 先将请输入姓名的提升语输出,然后从键盘输入内容,赋值给name变量特点:无论输入的是什么,得到的结果都是字符串类型,如果需要输入数字类型,请自行转换类型。
- print:对外输出信息数据
- input:从外部接收信息输入
逻辑判断
布尔数据类型
概念:布尔类型表示的是2个状态,即:真或假。其字面量为:True 表示真、False 表示假
注意:True和False的大小写
布尔用于存储一些逻辑判断的结果,逻辑判断在生活中或程序中非常常见,用来表示成立或不成立,即非黑即白
所以用True表示成立、False表示不成立。
其类型名为:bool
比较运算符
比较运算符主要用于对2个数据进行大小的比较。
可用运算符有:
==用于比较相等(注意是2个等于号)!=用于比较不相等>比较大于<比较小于>=比较大于等于<=比较小于等于
这些运算符统统产出的结果是:布尔类型
逻辑运算符
逻辑运算符主要对多个判断条件进行连接,进行统一判断。
主要有3个:
and用法:a and ba为True并且b为True,则结果为Trueor用法:a or ba为True或者b为True,则结果为Truenot用法:not aa为True则结果为False,反之a为False则结果为True,即取反
if语句
功能:做逻辑判断,即xxx是否满足,满足则做特定的事情。
语法:
if 条件: 条件满足后的代码 ... ...if是关键字,表示如果- 条件是表达式,要求必须必须必须是布尔类型结果
:不要忘记- 注意缩进有4个空格
- 表示层次关系,即条件满足后的代码,属于这个if判断
示例:
age = 19if age >= 18: print("成年")当满足条件,则输出成年
if else语句
功能:做逻辑判断,即满足xxx,则做特定的事情,否则,则做特定的事情
语法:
if 条件: 条件满足后的代码 ...else: 条件满足后的代码 ...- else和if是同层次,即缩进是一致的
- else后面不需要写条件了(使用if的条件)
:不要忘记- else内的代码,不要忘记缩进4个空格
示例:
money = int(input("请告诉我你还有多少钱:"))
if money >= 10000: print("去买个新电脑")
else: print("洗洗睡吧")if elif else语句
功能:做多个条件判断,对多个条件挨个做判断,满足则执行特定操作,如果都不满足则执行特定操作。
语法:
if 条件: 条件满足后的代码 ...elif 条件2: 条件满足后的代码 ...elif 条件3: 条件满足后的代码 .........elif 条件N: 条件满足后的代码 ...else: 条件满足后的代码 ...elif是关键字,不要写错elif可以写多个,无限制- 每一个
elif需要写条件 elif不可以单独存在,是搭配if后存在的- 注意缩进
- if和多个elif是有序且互斥
- 从if开始向下挨个判断,只要有满足的,则就不会理会其它了
- 不管有多少条件,就是
N选1
if嵌套
功能:在if判断内或else内或elif内,可以继续写if elif else
一般用于前置条件判断
语法:
if 条件: ... if 条件: ... else: ...elif 条件: ... if 条件: ... else: if ... elif ... else ...else: ... if 条件: if ... elif ... else ... else: ...如上语法,可以自由组合嵌套层次,层次不限制层数但是
一般建议不超过3层嵌套
- Python解释器不会晕,100层都搞的定
- 我们人会晕
猜数字案例,我们课上是3层嵌套完成的(3次猜测机会)
如果要避免嵌套还是有方法的:保密
循环
while循环基础语法
概念:循环是对特定的操作,当条件满足则持续执行下去,直到条件不满足为止。
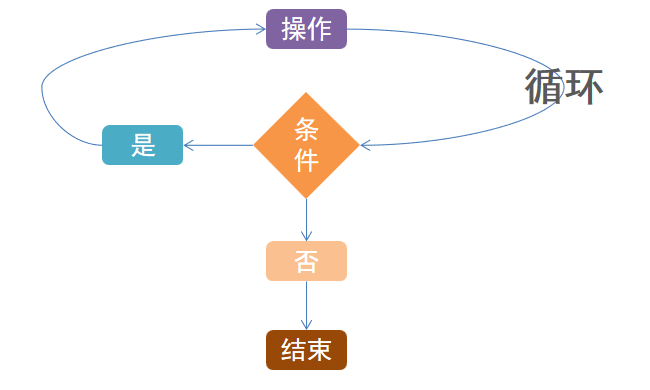
语法:
while 条件: 循环代码 ...while是关键字不要写错条件必须产出布尔结果缩进不要忘记
示例:
while 1 == 1: print("你好")这个代码满足循环语法,但是:无限循环
为了避免无限循环,我们自行在语法外引入限制,即循环三要素:
- 循环控制因子的创建
- 基于循环控制因子的条件判断
- 循环控制因子的更新
三要素合力,确保循环受限。
示例:
# 打印我喜欢你 10次# 基础循环,缺少控制,所以会导致无限执行# while True:# print("我喜欢你")
# 控制循环在有限次数内执行,有3个要素# 1. 循环控制因子(某个变量)# 2. 循环控制条件(基于因子做判断)# 3. 循环因子更新(修改因子的值)
# 控制因子num = 0
# 控制条件(基于因子)while num < 10: print("第%d次表白:我喜欢你" % num) num += 1 # 因子更新while循环嵌套
语法:
while 条件: ... ...
while 条件: ... ...如上是一个2层嵌套
使用嵌套循环一定注意:
空格的缩进,因为Python是通过空格缩进决定层次关系- 向右缩进,层次就低
案例:九九乘法表
row = 1 # 外层循环因子
while row <= 9: # 基于因子的条件
col = 1 # 内层循环因子 while col <= row: # 基于因子的条件 print(f"{col}*{row}={col*row}", end="\t") col += 1 # 内层循环因子更新
print() # 外层循环功能,换一行 row += 1 # 外层循环因子更新for循环基础语法
语法:
for 临时变量 in 待处理数据集: ... ...流程:从待处理数据集中,挨个取出内容,赋予临时变量,然后执行循环语句,循环往复。
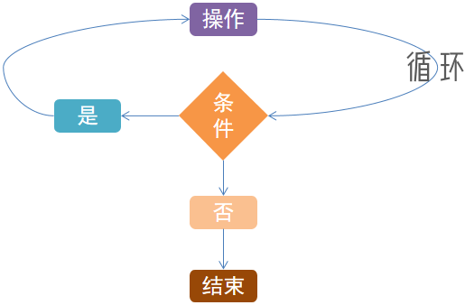
和while循环的流程对比,如下是while:
如下是for:
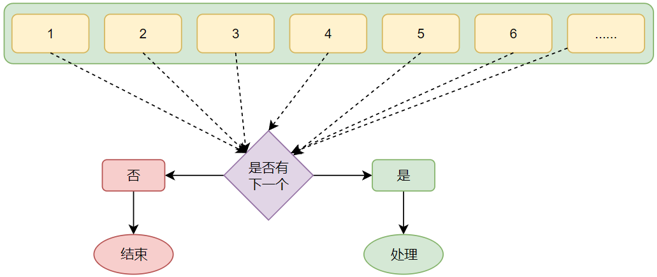
如上图可以看到,for循环对比while的区别在于:
- while循环有三要素(因子创建、条件判断、因子更新),for循环没有
- while有条件控制,则控制条件即可成为无限循环
- for循环没有条件,只是挨个取出待处理元素,实际上无法形成无限循环
可迭代对象(类型)
语法:
for 临时变量 in 待处理数据集: ... ...- 上述语法的待处理数据集,本质上应当是:可迭代对象(类型)
可迭代对象表示的是:支持挨个取出元素的类型,有如下类型属于可迭代类型:
字符串- 列表
- 元素
- 等
所以,字符串是属于可迭代类型则可以用于for循环如:
name = "itheima666你好"# 字符串可以被for循环使用,并且被逐个取出for x in name: print(x)range语句
range语句可以形成一个数字序列。
序列:有序的集合,比如:1, 2, 3, 4, 5, ... 就是数字序列
range语句形成的数字序列是可迭代类型(其本质是一个迭代器对象,等同于list列表)
语法1:
range(num):形成从0 开始,到num 结束(不包括num本身)的数字序列
- 如:
range(5)结果是:0, 1, 2, 3, 4
语法2:
range(num1, num2) :形成从num1开始,到num2结束(不含num2)的数字序列
- 如:
range(5, 10)结果是:5, 6, 7, 8, 9
语法3:
range(num1, num2, step) :形成从num1开始,到num2结束(不含num2)的数字序列,步长以step决定
- 如:
range(5, 10, 2)结果是:5, 7, 9 (注意步长是2)
变量作用域
在Python中变量是由其作用的范围的,离开其生效范围,则无法使用。
如下代码:
for x in range(5): age = 10 print(age)
print(age)此代码中,age变量创建是在for循环内部,所以age的生效范围,仅在for循环内,即
- 上述代码第三行,是OK的
- 第五行代码,是不OK的,因为脱离了age的生效范围
变量的生效范围一般是:
- 如果写在
:内,比如ifelifelsewhileforwith等- 则生效在
:所属的范围内
- 则生效在
- 如果写在文件中,则全文件生效
口诀:缩进靠左访问缩进靠右变量,不可以
反之,缩进靠右访问缩进靠左是OK的
continue关键字
作用:可以控制循环的执行,具体是:当循环代码遇到continue的时候,将跳过本次循环,直接进入下一次循环
示例:
for x in range(5): print("aaa") continue print("bbb")- 上述代码的
print("bbb")将永远无法执行,因为遇到continue循环直接进入下一次
break关键字
作用:可以控制循环的执行,具体是:当循环代码遇到break的时候,直接结束循环
示例:
for x in range(5): print("aaa") break print("bbb")- 上述代码仅输出一次
aaa后就结束,因为遇到break后,整个循环就结束了
注意:
continue和break
仅对循环有效(for和while)
在嵌套应用的时候,仅对所属的循环(for和while有效)
如上代码,break仅对第四行代码的这个for循环有效。
函数
概念
函数是:提前写好的、可以重复利用的、具有特定功能的代码片段
特点:
- 提前写好才能用
- 写好后,可以无限制重复用
- 功能是特定功能
主要作用:避免程序内重复的代码,一旦有重复的代码就可以封装为函数。
语法:
def 函数名([形参列表]): 函数内容 [return 返回值]调用函数:
函数名([实参列表])参数
参数分为:
- 形式参数:在书写(声明)函数的时候,
(声明)要求的传入参数 - 实际参数:在调用函数的时候,
实际传入的参数
特点:
-
支持任意个传入参数
-
多个传入参数用逗号分隔,如:
def add(x, y, z):return x + y + z如上三个参数,用逗号分隔
-
形参和实参是
一一对应,如:def add(x, y, z):return x + y + zadd(1, 3, 5)add函数在调用的时候,实际参数的数量和形式参数的数量要一致,同时1会提供给x,3给y,5给z,有对应关系
-
实参的传入类型不受限制,如下:
def add(x, y, z):return x + y + zadd("1", "2", "3")传入的时候自己注意,如果传入不兼容,可能报错
返回值
概念:函数对外提供的执行结果
语法:
def 函数名([形参列表]): 函数内容 [return 返回值]通过return对外提供
示例:
def add(x, y, z): return x + y + z
sum = add(1, 3, 5)sum就能得到return提供的值:9
None
在Python中有一个数据类型:NoneType ,它只有一个字面量:None
None表示:空、啥也没有
函数如果没有写return,则默认返回值是:None
或者函数也可以写return None 直接对外返回None
作用:
-
用在if判断中,因为None就等同于
False -
用在变量声明上,某些变量在写的时候,暂时不需要初始值,可以以None代替
age = None # 此时age不需要初始值,可以以None代替for i in range(5):age = int(input())# 为了避免作用域问题,age需要再for循环外部定义# for循环外定义的时候,不需要初始值,可以以None代替print("最后一个同学的年龄是:%d " % age) -
用于返回的返回值,只要有需要就可以返回None
函数的规范注释
语法:
def 函数名(参数): """ 函数说明文本 :param 参数1: 参数1的说明 :param 参数2: 参数2的说明 ... :param 参数N: 参数N的说明 :return: 返回值的说明 """ 函数体 return ...作用:规范代码,提高可读性,并提升B格
函数的嵌套调用
概念:嵌套调用就是在一个函数的函数体中调用了另一个函数
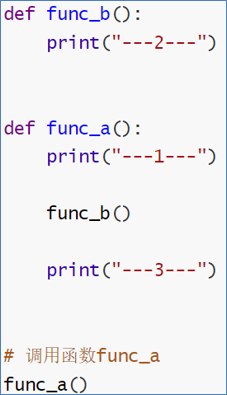
如图,为嵌套调用,结果是:1 2 3
特点:在函数执行的时候,如果遇到调用其它函数,则先执行这个函数,等函数运行完成后,在返回来继续执行未完成的工作。
见到函数就进入执行
示例:
"""嵌套调用的基本原则是:```遇到函数就进入执行```,执行完成后再回到当初的位置继续向下def func_b(): print("22222") func_a() print("33333")比如执行完222后,遇到函数了,则进入,将函数执行完成后再回来继续执行333"""
def func_a(): print("11111")
def func_b(): print("22222") func_a() print("33333")
def func_c(): print("44444") func_b() print("55555")
func_c()
# 结果是:# 4 -> 2 ->1 -> 3 -> 5局部变量
概念:写在函数内部的是局部变量,其作用范围只在函数内部有效。
def func(): # num是局部变量,作用域(生命周期)仅在函数内部有效 # 局部变量:写在函数内部的变量(也叫做临时变量) num = 100 print("内部输出", num)
func()
# 当函数执行完成后,临时变量(局部变量)num已经不存在了# 即num存在的时间只有在调用函数的那一会儿
# 在print语句执行的这个地方,num已经不存在了print("外部输出:", num)如上代码,15行访问num是错误的,因为num此时不存在了,即脱离了它应有的作用域范围。
全局变量
概念:没有写在函数内部的是全局变量,作用范围在函数内和外都生效。
"""全局变量就是:不定义在函数内部的变量"""# 全局变量num = 100 # 作用域在于整个代码
def func_a(): print(f"a: {num}")
def func_b(): num = 200 # 这个num是一个和全局num同名的局部变量 print(f"b: {num}") # 此时访问的num是局部变量num
func_a()func_b()
print(f"外部:{num}")如上代码,num就是全局,在函数内和函数外均可用
global关键字
作用:在函数内部声明使用的变量是全局变量
演示:
num = 100 # 作用域在于整个代码def func_a(): print(f"a: {num}")
def func_b(): num = 200 # 这个num是一个和全局num同名的局部变量 print(f"b: {num}") # 此时访问的num是局部变量num
func_a()func_b()
print(f"外部:{num}")函数的输出结果是:
a:100b:200外部:100函数b对num的修改是失效的,因为这个num在函数b中是写了一个和全局num同名的局部变量。
解决这个问题使用global关键字即可,如下代码:
"""全局变量就是:不定义在函数内部的变量"""# 全局变量num = 100 # 作用域在于整个代码
def func_a(): print(f"a: {num}")
def func_b(): global num # 在此函数内部使用的num是全局变量 num = 200 # 这个num就是访问全局变量,修改他的值 print(f"b: {num}") # 此时访问的num是全局变量num
func_a()func_b()
print(f"外部:{num}")看13 行,通过global关键字可以在函数内部声明,num为全局变量,对num的所有使用都是用全局num
数据容器
概念
数据容器:一种数据类型,可以存储多个元素在内。
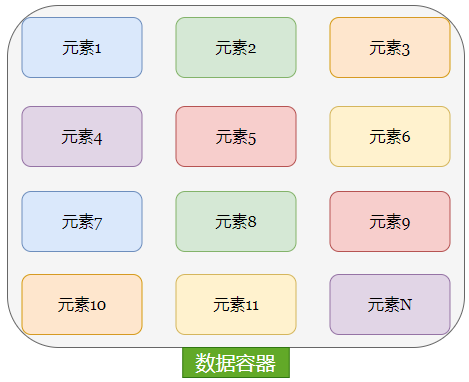
根据是否可以修改、是否允许重复、是否有序等等特点数据容器有如下类型:
- 列表(list)
- 元组(tuple)
- 字符串(string、str)
- 字典(dictate)
- 集合(set)
列表
list(列表)
特点:
- 可以支持非常多的元素在内(
2**63 -1) - 支持多种不同元素类型的混装
- 支持修改
- 内部数据有序(有下标索引)
- 支持重复元素
类型名:list
通过type语句输出的类型字符串是:<class list>
语法
字面量
[元素, 元素, ..., 元素]
[1, 2, 3]["itheima", "你好"]变量
name = ["itheima", "666"]ages = [11, 22, 33]空list
name = []name = list()嵌套
ages = [ [1,2,3], [4,5,6]]下标访问
列表元素有下标值(每一个元素的序号)
- 从前到后(从左到右)下标是0、1、2、…、N 即从0开始递增
- 从后到钱(从右到左)下标是-1、-2、-3、…、-N 即从-1开始递减
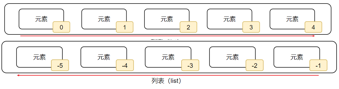
可以通过下标值访问列表的特定位置的元素,如下
nums = [1, 3, 5]下标是:[ 1, 3, 5] 0 1 2 正向下标 -3 -2 -1 反向下标
通过下标访问nums[0] # 得到1num[-2] # 得到3操作方法
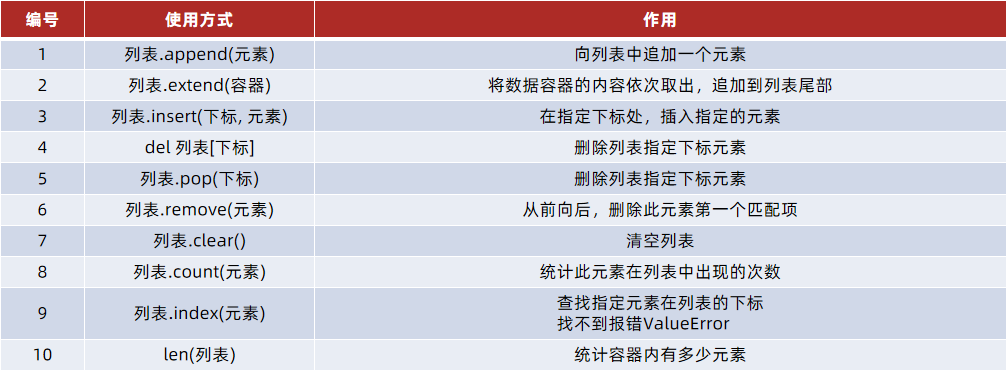
不需要背下来,练习两次即可。
用多了自然就记住了,用不到硬记也是个忘
需要用的时候有个大概概念印象即可查询AI等工具或翻看笔记
元组
特点
- 可以支持非常多的元素在内(
2**63 -1) - 支持多种不同元素类型的混装
不支持修改- 内部数据有序(有下标索引)
- 支持重复元素
列表当一创建出来后,就固定了内容不变(内部嵌套list除外)
语法
字面量
(元素, ..., 元素)
(1, 2, 3)
("itheima", )注意:
元组内如果只有1个元素,写起来必须有逗号在内,如:(1, ) ("itheima", )
不写逗号则不是元素类型
变量
name = ("周杰伦", "林军杰")nums = (1, 2, 3)空元组
name = ()name = tuple()嵌套(元组也支持嵌套)
age = ( (1, 2, 3), (4, 5, 6) )元组内有list
当元组内有list的时候,还是遵循元组不可改的特点,但是list内的元素可以修改。
比如:
age = (1, 2, [3, 4, 5])则内部的这个list的内容是可以改的。
这是因为元组在存储的时候,本质上存的是:
(1, 2, 地址)即,存放的是list的内存地址(指针)值。
所以,只要这个地址不变即可,就满足元组不可修改的特性了。
至于地址指向的内容区域的内容是否发生变化,则和元组无关。
所以下列操作中
nums = (1, 2, [5, 6, 7])# 正常操作nums[2][2] = 10 # 可以的nums[2].append(11) # 可以的
# 错误操作nums[2] = [1, 2, 3] # 不可以,相当于用新list去替换老的list,即记录的内存地址要变,是不允许的操作方法
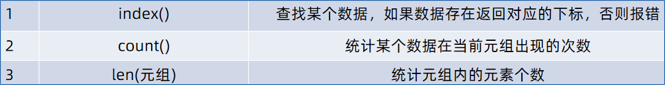
因为元组不可变,所以操作方法也少了很多。
字符串
字符串:也是数据容器,其内部存放的元素固定为字符,是多个字符的集合体,称之为字符的串串。
字符串特点
- 可以支持非常多的元素在内(
2**63 -1) 仅存放字符数据不支持修改- 内部数据有序(
有下标索引) - 支持重复元素
语法
name = "itheima"name = 'itheima'name = """itheima"""常用操作方法
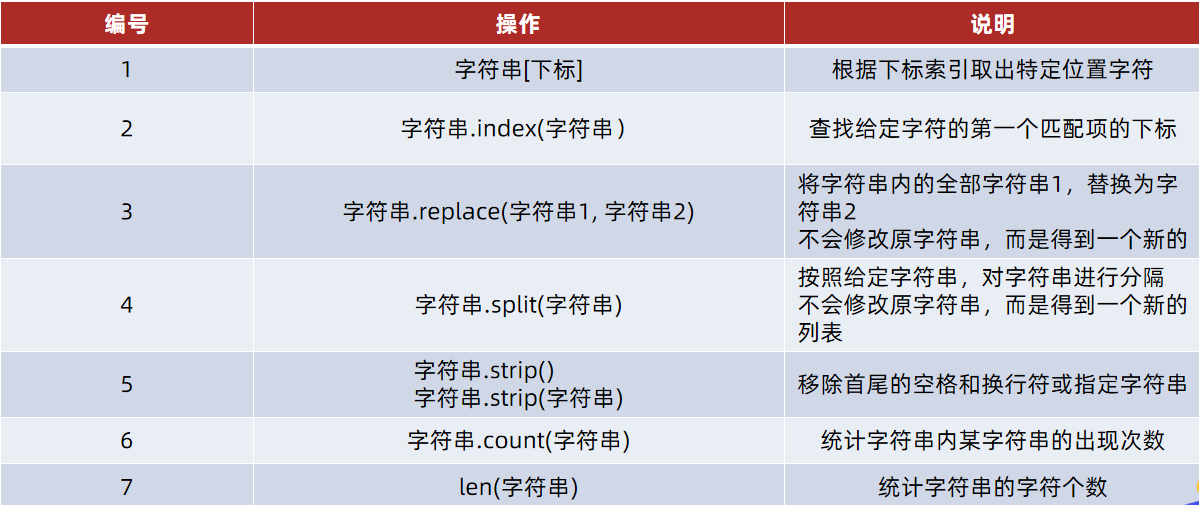
重点方法:
- replace
- split
- strip
可迭代类型
到目前为止,我们学习到的数据类型中,可迭代类型(可用于for循环的)有:
- 列表
- 元组
- 字符串
带有下标的,都可以用于for循环
序列的切片
概念:序列是指有序的、有下标索引的数据容器。
序列是支持切片,语法:
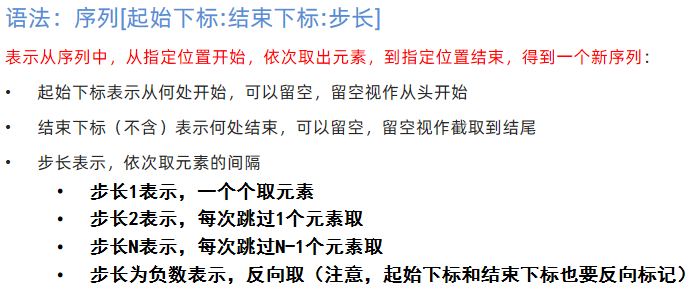
示例
lst = ["aa", "bb", 3, 5, 6]# 取出来"bb", 3print(lst[1:3])
# 取出来 5, 3, "bb"print(lst[-2:-5:-1])# 反向操作即步长为负数,要求 开始下标在结束下标的右侧
t = (1, 3, 5, 7, 9, 11, 13, 15, 17)# 取出来 3 7print(t[1:4:2])# 取出来 15, 9, 3print(t[-2:0:-3])
name = "itheima 666 and itcast"# 反转字符串print(name[::-1])# d a 6 6 aprint(name[-8:5:-2])# 取出来666print(name[8:11]) # 步长不写默认为1
"""序列都可以切片(序列就是有下标的)- 字符串- 元组- 列表"""集合
特点:
- 可以支持非常多的元素在内(
2**63 -1) - 存放任意数据类型,支持混装
- 支持修改
内部数据无序(无下标)不支持重复元素
集合内部是去重的,重复的元素只保留一份
因为去重,所以内部无序(实际顺序是hash表顺序、如果hash算法不同,顺序可能不同)
语法:
{元素, ..., ..., 元素}字面量
{1, 2, 3, 3, 3} # 实际存储是 {1, 2, 3} 内部去重了变量
s = {1, 2, 3}空集合
s = set()# 注意,s = {} 不是空集合,而是空字典嵌套
s = {{1,2}, {3, 4}, {5, 6}}常用操作
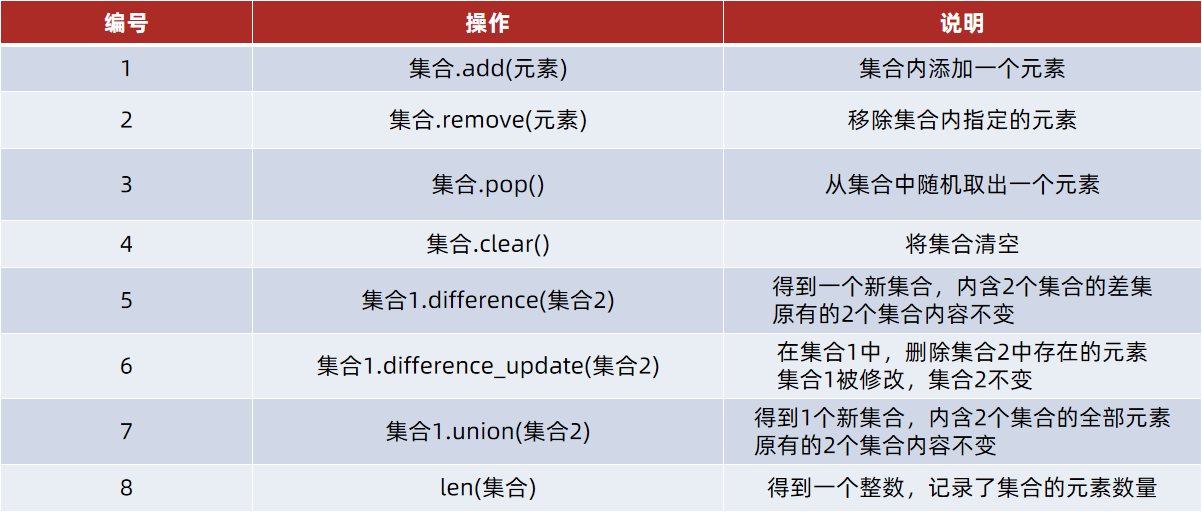
这些操作基本用不到,写两遍即可
字典
概念:字典内部是存放了一堆的键值对,键值对是:Key:Value的对
在字典中Key 不允许重复,如果重复则新数据覆盖老数据。
字典可以基于Key 去找到其对应的Value
- 可以支持非常多的元素在内(
2**63 -1) - 存放任意数据类型,支持混装
- Key数据类型不可为字典,一般类型用:字符串、整数
- Value数据类型随意,不限制
- 支持修改
内部数据无序(无下标)不支持重复Key
语法
空字典
d = {}d = dict()字面量
{"a": 1, "b": 2}# 是Key:Value的形式变量
d = {"周杰轮": 99, "王力鸿": 88, "林军杰": 77}嵌套
d = { "周杰轮": {"语文": 99, "数学": 88, "英语": 22}, "林军杰": {"语文": 88, "数学": 66, "英语": 21}, "王力鸿": {"语文": 66, "数学": 11, "英语": 33},}
d = { "周杰轮": ["唱", "跳", "rap"], "林军杰": ["吃", "喝", "玩"], "王力鸿": ["睡", "呆", "憨"]}常用操作
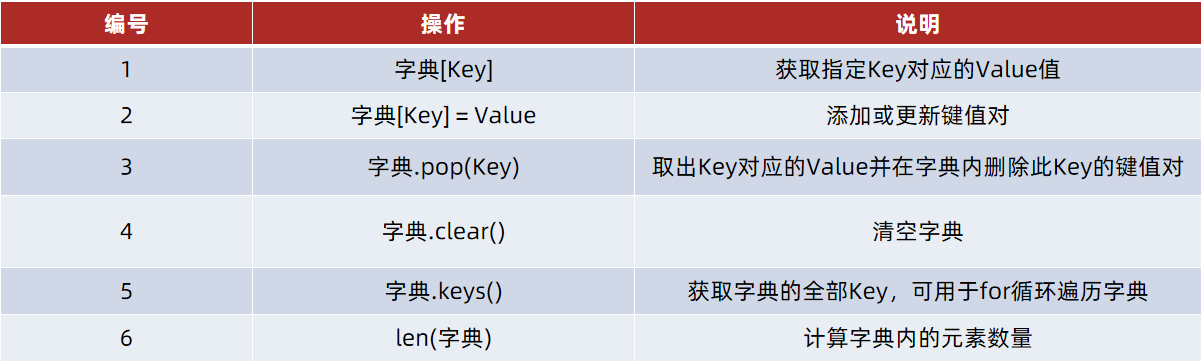
数据容器的对比
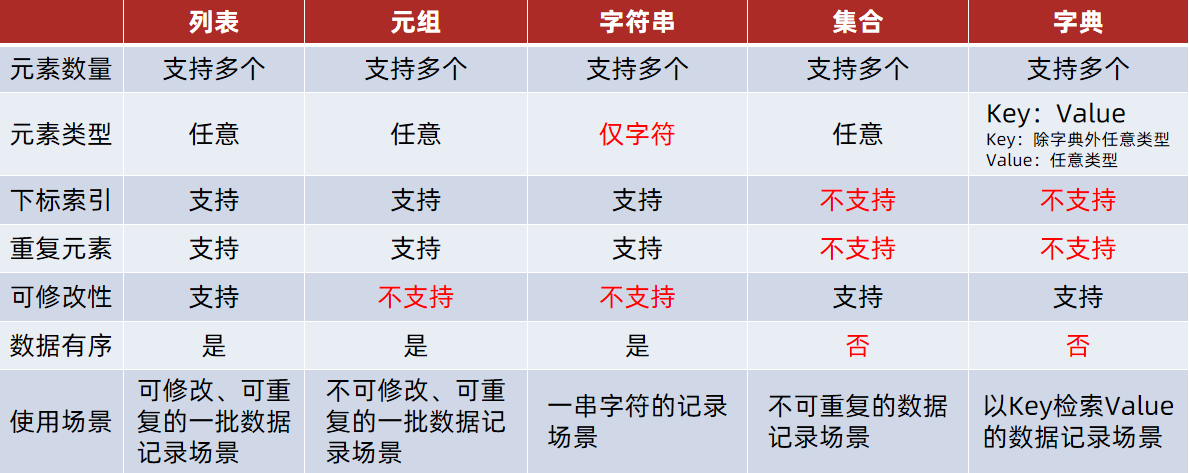
数据容器的通用操作
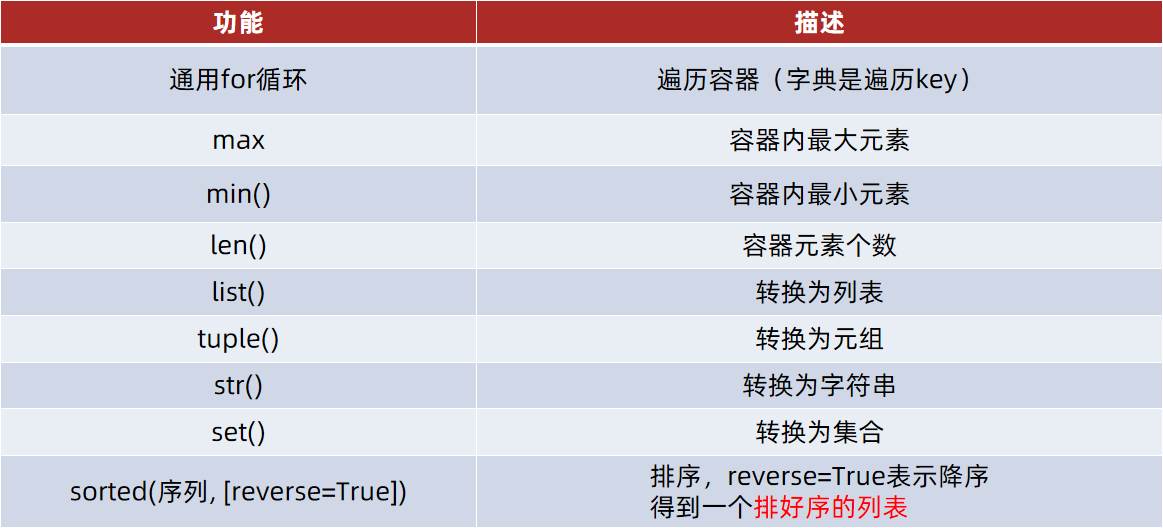
字符串的大小比较
字符串(中文、英文、数字、符号等)都是存储的数字,显示的是字符串
- 英文、数字、符号,都是以ASCII码表,比如”a”对应97 “A”对应65
- 中文,一般以UTF-8或GBK编码(UTF-8更通用),也有对应的数字
所以字符串比较本质是比较各个字符的数字大小。
字符串是按位比较,一位位比,每一个位出结果则整体大小就确定。
比如:
abe大于abc以为a==ab==be>c在第三位确定了大小abc大于ab因为a==a b==b但是c > 啥也没有21大于123因为"2" > "1"则直接出结果
ASCII码表如下:
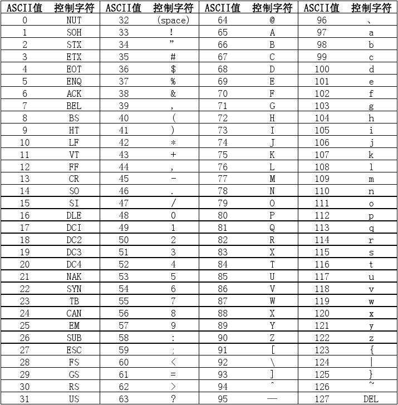
常用口诀(用于英文和数字)
- 小写大于大写字母
- 大写字母大于数字
- 其余查表吧
函数高阶应用
返回多个返回值
语法:
def func(...): ... return 值,值,...,值 # 返回多个值,逗号分隔即可
# 调用的时候用多个变量接收变量,变量,...,变量 = func()示例
def func(...): return 1, 2
x, y = func()# x接收1# y接收2原理
return 1, 2 这种写法,本质上是返回了元组 ,即返回的是:(1, 2)
所以我们用2个变量接收,如:x, y = func() 会自动将元组的第一个元素赋值给x,第二个元素赋值给y
即:
def func(...): return 1, 2
x = func()# x的值是:(1, 2) 是一个元组函数的多种传参形式
位置传参
按照形式参数写的时候的位置,在调用函数的时候,传入实际参数。
实际参数和形式参数是一一对应的。
示例:
def func(x, y, z): ...
func(1, 2, 3)此时:1传入给x、2传入给y、3传入给z
- 数量一致
- 顺序一致
关键字传参
语法:形式参数名=实际参数值
示例
def func(x, y, z): ...
func(x=1, y=2, z=3)传入参数的时候,是指定了形式参数名称,这样的话,可以不按照形式参数的顺序进行传入。
比如:
def func(x, y, z): ...
func(y=2, z=3, x=1)这样写,同样是 x得到1、y得到2、z得到3
同时关键字传入参数和位置参数可以混用,如下
def func(x, y, z): ...
func(1, 2, z=3)关键字传参的写法,必须在位置传参的右侧。即如下写法是错误的
func(x=1, 2, z=3)x=1写在了位置参数的左侧,不符合要求
缺省参数(默认值参数)
在编写函数的时候,可以给某个参数提供默认值,此参数即可实现
- 调用的时候,不传入值,则使用默认值
- 如果传入值,则使用传入值
语法:
def func(x, y, z=10): ...在调用的时候:
- 写的是:
func(1, 2)可以看到只给x和y传入值,没有提供z的值,则z使用默认值10 - 写的是:
func(1, 2, 3)则z使用提供的3
注意,带有默认值的参数,必须在没有默认值参数的右侧。
如下写法是错误的:
def func(x, y=1, z): ...y这个带有默认值的参数,在非默认值参数z的左侧,是不符合语法要求,错误。
不定长参数(元组接收)
概念:可以写一个参数,表示不定长(参数数量不确定),将传入的参数全部收集到一个元组内。
语法:
def func(x, y, *z): ...- x和y是普通参数
- z是不定长(元组接受)的参数,z就是一个元组,收集传入的实际参数
示例
def func(x, y, *z): ...
func(1, 2, 3, 4, 5, 6, 7, 8, 9)如上代码:
- 1和2是提供给普通参数x和y
- 后续的3, 4, 5, 6, 7, 8, 9 全部存入了参数z中
- 参数z是一个元组
不定长参数(字典接收)
概念:可以写一个参数,表示不定长(参数数量不确定),将传入的参数全部收集到一个字典内。
语法:
def func(x, y, **z): ...- x和y是普通参数
- z是不定长(元组接受)的参数,z就是一个元组,收集传入的实际参数
用字典接收是2个
*号
示例
def func(x, y, **z): ...
func(1, 2, id=1,name='a',addr='shanghai',gender='男')如上:
- 1和2传给普通参数x和y
- 后续的id=1,name=‘a’,addr=‘shanghai’,gender=‘男’会被收集为字典,存入变量z(字典)中
- 即z内部的数据是4个键值对
不定长元组接收和不定长字典接收混用
def func(name, age, *args, **kwargs): print(f"我是{name}, 年龄{age}岁, 我的爱好有:", end="") for i in args: # args是元组 print(i, end=" ")
print() print("我的其它信息:", end=" ")
for key in kwargs: # kwargs是字典 print(f"{key}: {kwargs[key]}", end="、")
print()
func("周杰轮", 11, "唱", "rap", "跳", "打篮球", addr="石岩", id=123, money=20000)如上代码,可以实现传入参数的2种不定长方式的混合使用。
- “周杰轮”, 11是提供给name和age(基于位置传参)
"唱", "rap", "跳", "打篮球"提供给不定长参数*args,被收集到args这个元组内addr="石岩", id=123, money=20000提供给不定长参数**kwargs,被收集到kwargs这个字典内
函数作为参数传递
概念:一般使用函数,都是传入的数据,如数字、字符串、数据容器。这种传递我们称之为:数据的传递。
除此以外,函数也可以接收函数作为参数传递,这样就不是传递的数据了,而是传递的计算逻辑(函数)
示例
"""写函数的时候:- 形式参数,可以接收函数传入- 实际参数,真的可以传入一个函数
这种写法称之为函数式编程,核心思想是:传入的是计算逻辑"""def func(compute): # 被计算数据固定为1和2,要计算的逻辑取决于传入的compute函数 result = compute(1, 2) print(result)
def compute1(x, y): return x + ydef compute2(x, y): return x - ydef compute3(x, y): return x * ydef compute4(x, y): return x / y
# 传入的是compute函数,而非变量和数据# 传的是函数也就是传的是计算的逻辑func(compute1)func(compute2)func(compute3)func(compute4)如上代码,传递的compute 1 2 3 4 就是4个不同的函数,代表4种不同的计算逻辑。
函数是可以作为参数传递的。
lambda匿名函数
语法:
lambda 形参列表: 函数体(一行)作用:用来快速实现一个匿名的函数
- 带有名字的函数是:
def 函数名(...) ...- 有名字可以重复调用
- 匿名函数就是:
lambda x, y: ...- 没有名字,只是临时用一次
示例
def func(compute): # 被计算数据固定为1和2,要计算的逻辑取决于传入的compute函数 result = compute(1, 2) print(result)
# 调用func4次,完成+-*/# 这些函数仅用一次,不用于重复使用,所以用lambda快速实现func(lambda x, y: x + y)func(lambda x, y: x - y)func(lambda x, y: x * y)func(lambda x, y: x / y)- 上面调用的4次func,传入的4个不同的计算逻辑
- 这4个不同的计算逻辑就是4个匿名函数,只用一次
在以后的功能开发中,会遇到一些仅需要传入计算逻辑(函数)的函数,就可以用lambda快速实现。
匿名函数也可以有名字,用变量接收即可,如下:
chengfa = lambda x, y: x * yprint(chengfa(1, 3))这种写法一般不用,要是想给函数个名字,为何不用def
文件操作
文件编码
计算机只认识0和1,包括内存、硬盘、网线等等这些IT设备,都是只认识0和1二进制。
为了能够存储丰富的文本数据在硬盘里面,我们需要将文本转换为二进制存储。
动作:
- 写入:文本 ->转换->二进制->存入硬盘
- 读取:读取硬盘->二进制->转换->文本
转换的动作就是二进制和文本之间的对照关系,这个对照关系,我们称之为编码。
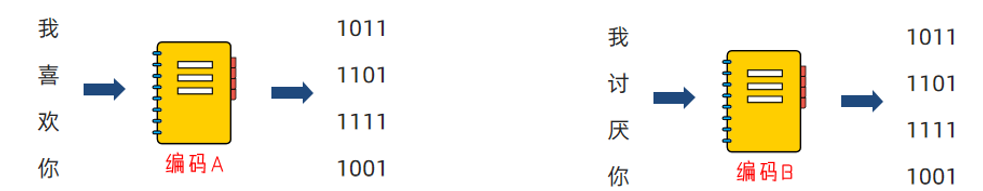
如上图,如果用编码表A存储数据,以编码表B解析数据,则会出现问题,无法解析或解析错误。
所以我们的文件在保持的时候有编码,在用的时候也有编码,要确保是一致的,否则有问题
当前,全球范围内最火的编码是:UTF-8 ,这是全球通用编码表,支持全世界范围内绝大多数语言。
没特殊需求,首选UTF8,同时UTF8也是绝大多数软件的默认编码。
偶尔我们可能还会见到GBK编码,这个是中文专用编码,在某些老旧软件系统中还有。
文件的打开
Python操作文件,就4个操作:
- 打开
- 关闭
- 读取
- 写入
打开文件的语法:
f = open(file, mode, encoding=?)- 参数1,表示文件的路径(在哪)
- 参数2,工作模式
- 参数3,编码,无脑UTF-8(有指定编码除外)
返回值变量是一个File类型的类对象,其内置有操作方法(类型列表)
比如:
f.close()调用close函数是需要用f.点出来的
工作模式:
r,只读w,覆盖写入a,追加写入rb,只读(二进制)wb,覆盖写入(二进制)ab,追加写入(二进制)
文件关闭
文件关闭和文件打开是配套操作
语法:
f = open()f.close()调用f.close() 即可关闭文件
注意:f.close() 还会同步flush 写入缓冲区
文件读取
前置要求:需要先打开文件
假设是:f = open(...)
read([num])方法
content = f.read()可以读取整个文件的内容,返回字符串
content = f.read(5)读取5个长度的内容,返回作为字符串
readlines方法
lst = f.readlines()按照行进行切分,将全部行放入list表中,返回
注意:每一行都会在结尾,附带
\n需要自行处理掉
readline方法
line_str = f.readline()调用一次readline 就读取一行,返回作为字符串
如果要读取多行,要自行多次调用
同样每次读取的一行后面会带有
\n需要自行处理掉
循环读取
方式1
for line in f: ... # line 就是每一行的字符串方式2
for line in f.readlines(): ... # line 就是每一行的字符串with open 方式
语法:
with open(...) as f: ...这种写法是一种快捷写法,包含了:打开、操作、关闭
无需写f.close() 会自动关闭文件的。
异常
概念
异常称之为:BUG(虫子)
异常:程序在运行的时候出现问题,导致程序无法继续的软件缺陷。
异常捕获
为何
我们无法确保全部代码都是100%OK的
在
- 可能出现问题的代码上
- 做如果出现问题后的预案
这就是异常捕获的意义。
语法
try: 可能有异常的代码except 异常类型 as 变量: 出现异常的处理代码except 异常类型 as 变量: 出现异常的处理代码......except 异常类型 as 变量: 出现异常的处理代码else: 没有异常的处理代码finally: 有没有异常都会执行的代码try只有在try内部的代码,才会被捕获异常except是匹配机制,用来匹配特定异常- 特殊异常类型:
Exception所有异常的父类(顶级异常),任何异常都可以用Exception抓住
- 特殊异常类型:
else(可选),没有异常的时候,会进入else的语句段finally(可选)有没有异常,都会执行的
异常的传递性
如图:
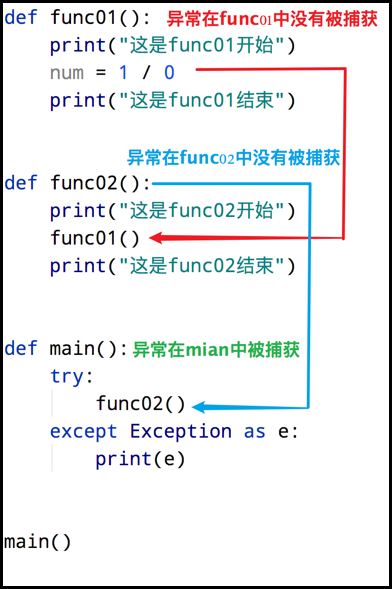
异常会从func01中传递到func02 传递到main 函数中
即异常会向上(函数层级)不停的传递,直到被捕获为止。
如果没有被捕获到,则进行报错,停止程序。
报错的函数链条
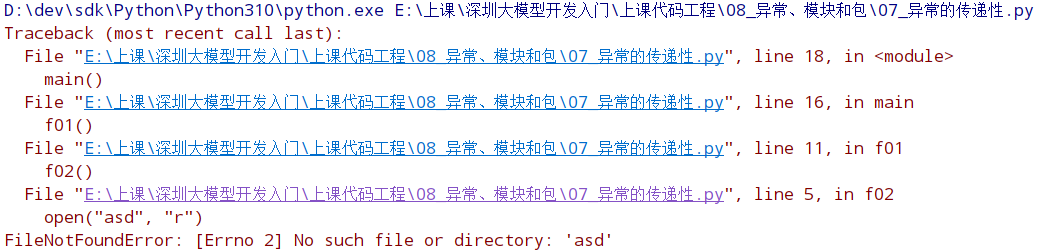
如图,异常有传递性,在出现错误后,报错信息里面可以将传递的链条都提示出来
我们可以根据这个链条找到具体的报错(一般就找最后一行)
模块&包
模块
概念
模块:一个完整的.py文件,里面包含相关Python代码(含有函数、类、变量等),称之为一个模块。
简单来说:一个python代码文件就是一个模块。
用途
可以通过import from 语句,从其它模块(代码文件)中导入相关的函数和变量和类等资源去使用
我们写代码不可能将全部代码都写到一个文件内,可以拆分成多个文件,通过import的方式从其它文件引用功能
语法
[from 包|模块] import (包|模块|函数|变量|类...) [as 别名][]代表可选|在语法中表示 或()在语法中表示必写
示例
代码文件B.py 中有函数:B1 B2 B3
在代码文件A中想要使用这三个函数,可以有如下写法:
方法1
import BB.B1()B.B2()
# 或者带有别名import B as bb.B1()b.B2()方法2
from B import B1B1()# 此时无法使用B2 B3 因为没有导入
# 或者from B import B1, B2 # 此时无法使用B3 因为没有导入B1()B2()方法3
from B import *B1()B2()B3()这种写法不建议,因为不能确定B1 B2 B3和模块B的关系
Python内置变量
__name__ 变量
__name__ 变量是Python自带的,任何一个Python代码文件内部,都是隐式(你不写也有)的附带这个变量。
功能:
- 当这个代码文件,作为Python程序执行的时候,此变量记录值是:
__main__ - 当这个代码文件,作为模块被其它代码文件导入的时候,此变量记录值是:
代码文件名本身
基于这个特性,我们可以区分这个文件是执行了还是被导入了。
常见用法:
if __name__ == '__main__': xxx()当此文件被作为程序执行,才会执行xxx函数
如果是作为模块被其它文件导入,上述的if 判断无法成立,则xxx不会执行
__all__ 变量
此变量也是隐式存在于每一个代码文件中,默认值是 *
它表示的是,如果文件被from 模块 import * 被导入,则内部的哪些函数可以被* 导入
默认,是全部
如果不想要全部的话,可以手动赋值此变量。示例如下:
文件B
__all__ = ["B1", "B2"]
def B1(): ...def B2(): ...def B3(): ...当在文件A中使用语句:from B import * 则只会自动导入B的B1 和B2 2个函数,因为__all__ 变量内记录的只有这2个
如果删除__all__ 变量,则可以自动导入全部的函数。
包
概念:Python的包是一个特殊文件夹,这个文件夹内包含:
__init__.py的文件- 其它模块(.py)文件
简单来说,包就是管理非常多模块的一个层级。
比如新建一个包,只需要:
- 创建一个文件夹,在文件夹内创建
__init__.py文件 - 将其它模块(
.py)文件放入此文件夹
此时就得到了一个包。
示例:
文件夹my_package内有
__init__.py文件- 有
B.py模块文件,这个模块内提供B1B2B3三个函数
如果想要使用这三个函数可以:
# 方式1(不推荐不好写)import my_package.Bmy_package.B.B1()my_package.B.B2()my_package.B.B3()
# 方式2 推荐好写from my_package import BB.B1()B.B2()B.B3()
# 方式3 也推荐from my_package.B import B1B1() # 此时无法用B2 和B3 因为没导入
# 方式4 不推荐 可读性不好from my_package import *B.B1()B.B2()B.B3()
# 方式5 不推荐 可读性不好from my_package.B import *B1()B2()B3()__init__.py文件内置变量__all__
在这个文件内同样有__all__ 变量,可以控制from 包 import * 语句中,哪些模块被自动导入。
示例:
包my_package 内有 3个模块A.py B.py C.py 以及__init__.py文件
在__init__.py 文件内是空的,则
from my_package import *这个写法,无法使用A、B、C任何的模块
在__init__.py 文件内写上:__all__ = ["A", "B"] 则
from my_package import *这个写法,可以使用A和B2个模块,无法用C这个模块
安装第三方包
语法:
pip install 包名称如果网络不好可以用国内网址,如下:
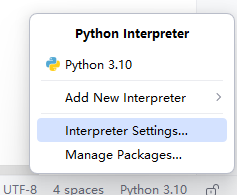
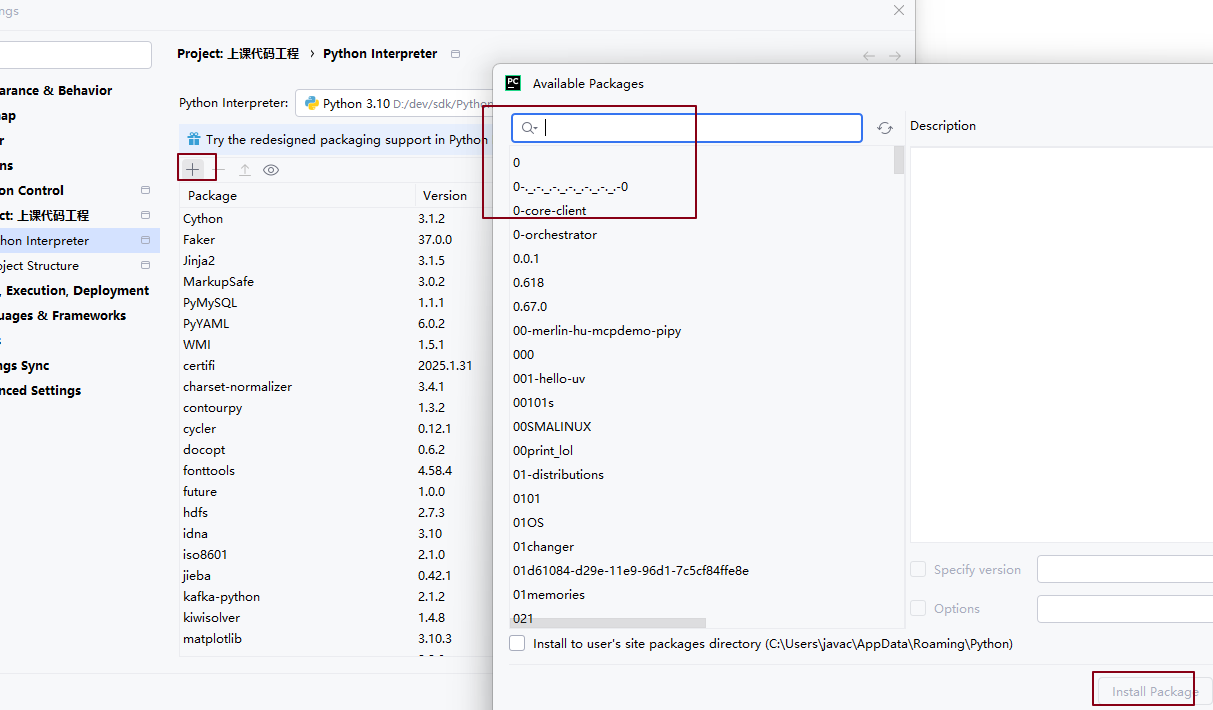
pip install -i https://pypi.tuna.tsinghua.edu.cn/simple 包名称在PyCharm内,通过鼠标点击也可以安装:
AI大模型开发-Linux重点笔记
虚拟机安装
VMware安装后的验证
快捷键:win + r 打开运行窗口
输入:ncpa.cpl回车,可以看到自己电脑的网络适配器
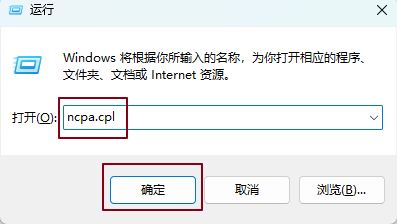
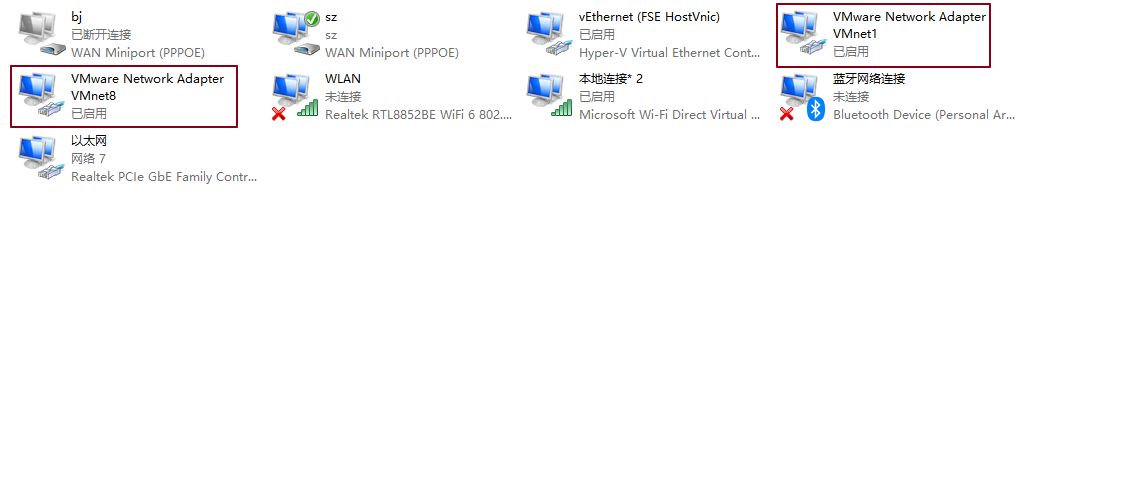
当安装完成后,确认有
VMnet1好VMnet82个虚拟网卡
Ubuntu系统安装流程
确认有系统安装光盘,在给同学们的资料中:资料/虚拟机/ubuntu-20.04.6-desktop-amd64.iso 这个就是操作系统安装光盘。
后续流程如下截图过程
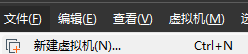
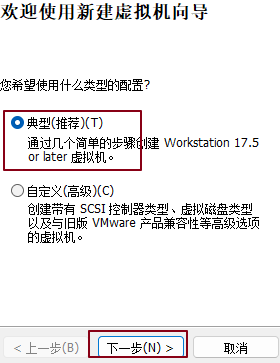
-
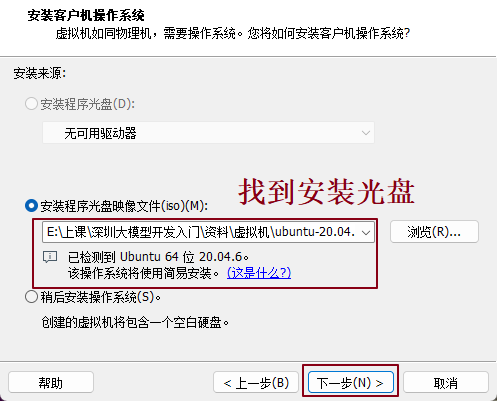
image-20250724115817905 -
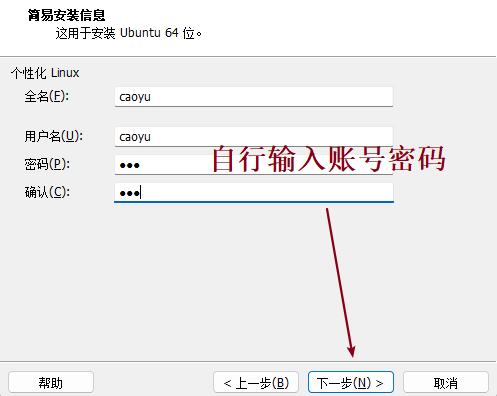
image-20250724115848650 -
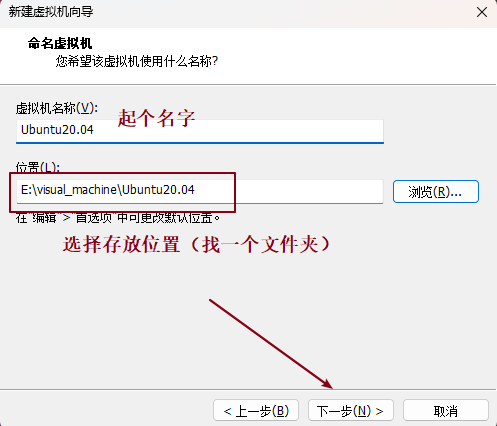
image-20250724115941127 -
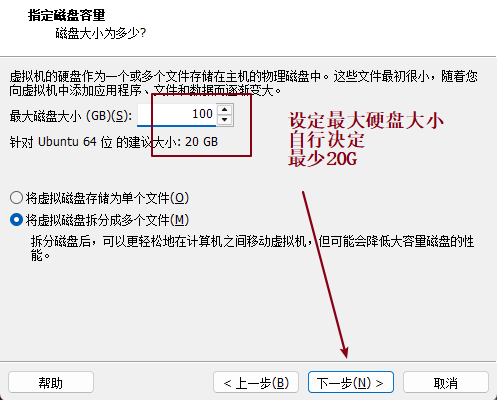
image-20250724120008760 -
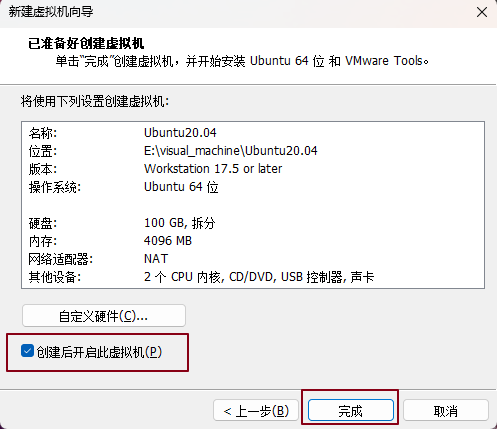
image-20250724120024674 -
进入安装流程
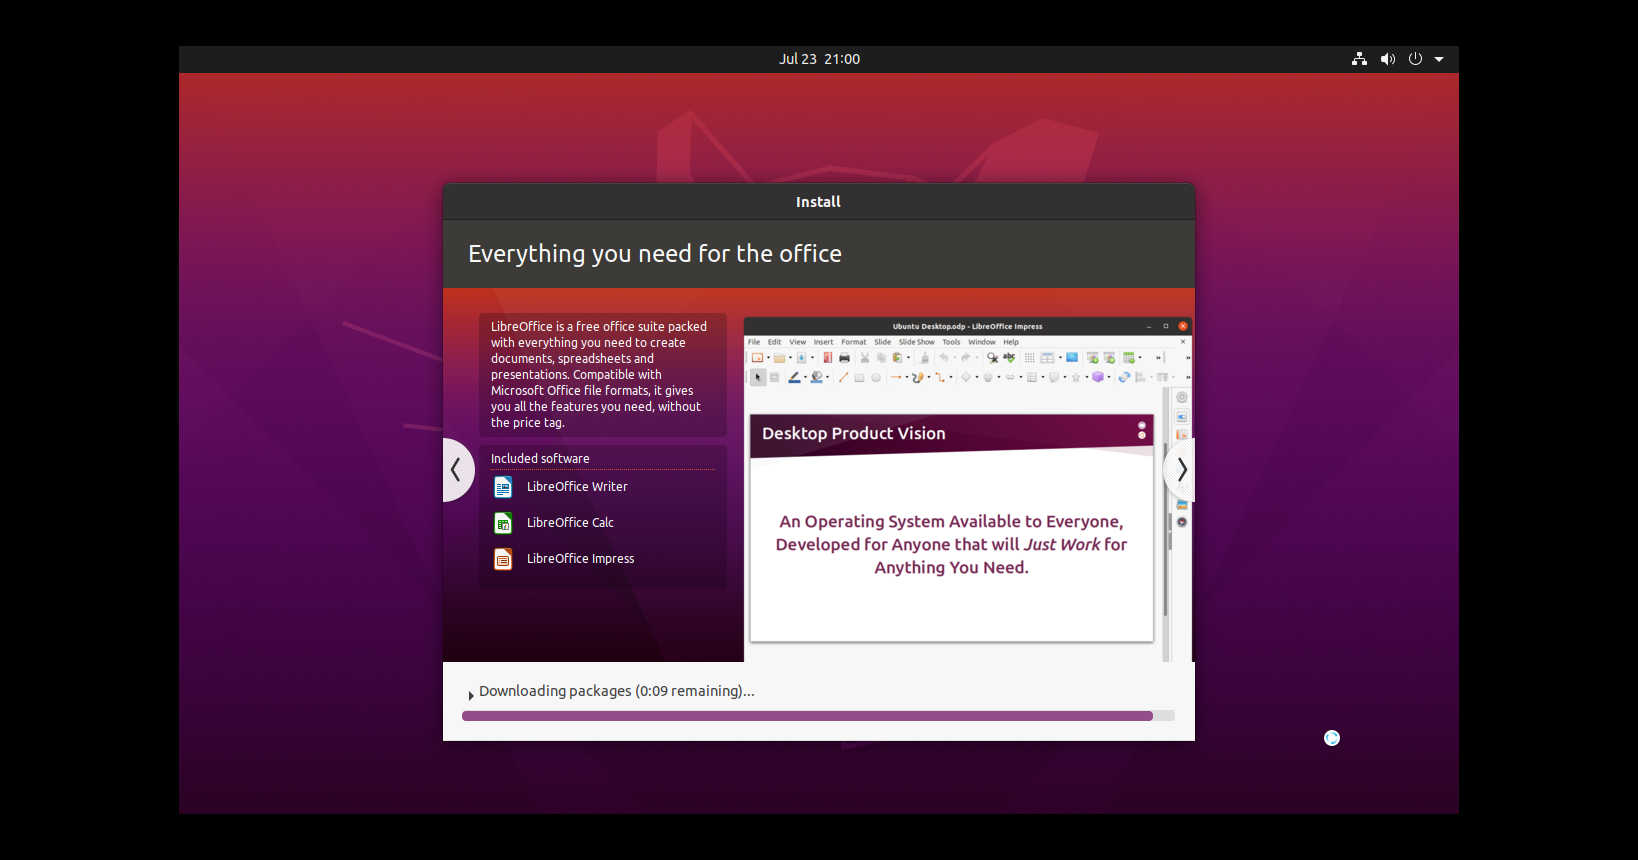
image-20250724120036926 安装过程全自动化,无需人工干预,等待即可。
安装后打快照
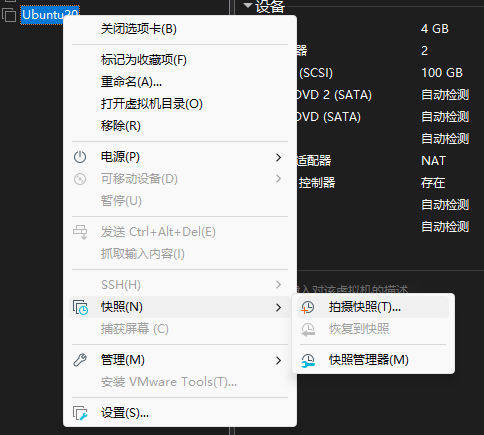
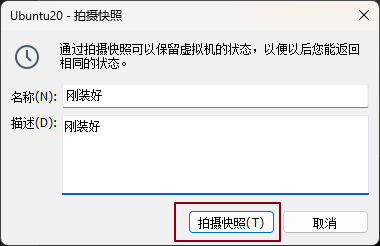
如图,就做了快照备份,后续有问题可以随时回退
建议每隔一段时间就打个快照
检查是否联网
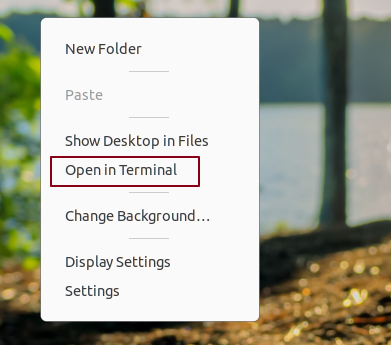
如上图在虚拟机的桌面,右键点击Open in Terminal
然后输入命令:ip addr 可以看到虚拟机的IP地址,如下图
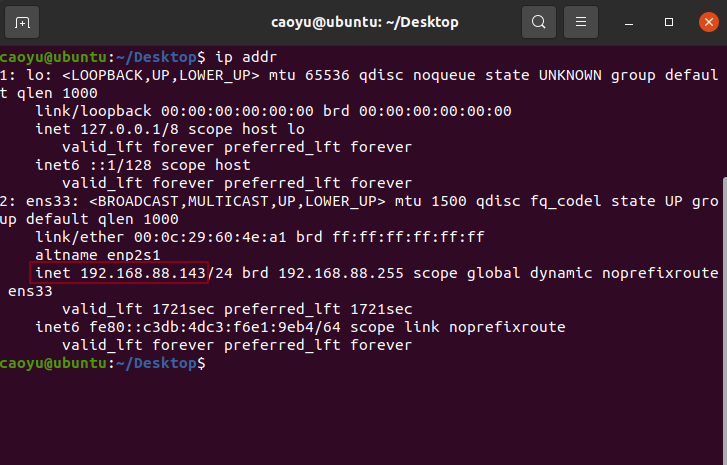
或者执行命令:ping baidu.com
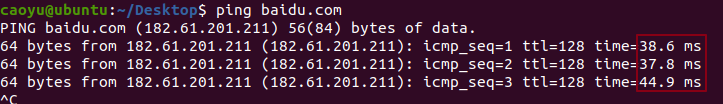
能看到和百度网址的延迟毫秒信息即可
问题
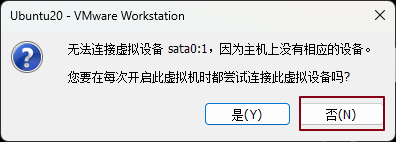
启动虚拟机,遇到这个,直接点击否即可。
基础命令
命令基础格式
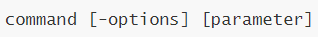
- command 命令本体,必写
- options可选选项,控制命令的细节
- parameter,可选参数,控制命令的指向目标
ls命令
ls [-a -l -h] [参数]参数的作用
决定ls命令要查看的目标
ls / 查看根目录内容
ls /usr 查看/usr目录内容
-a选项
查看全部文件,包括隐藏文件,都显示
在Linux中以.开头的文件是隐藏文件和隐藏文件夹
-l选项
以列表形式查看内容
不用-l 以平铺形式查看
-h选项
以更容易理解的方式显示文件大小(以K M G为单位)
HOME目录
在Linux系统中每一个用户都有的专属文件夹,有全部操作权限
默认路径是:/home/用户名
比如用户名:caoyu则路径是:/home/caoyu
当前工作目录
终端软件当前所在的目录,可以通过pwd 命令查看
隐藏文件
以.开头的文件和文件夹是默认隐藏的需要用ls -a 的模式查看
cd命令
更改工作目录
语法:
cd 路径- 绝对、相对路径都可以
pwd命令
查看当前的工作目录
语法:
pwd没有选项、没有参数
相对、绝对路径
相对:以当前所在文件夹为路径起点- 绝对:以根目录所在文件夹为路径起点
路径符号
.,当前目录..,上一级目录~,用户的家目录-,上一次的目录
mkdir命令
语法:
mkdir [-p] 路径功能:创建指定文件夹
-p连续创建多层级的文件夹,如mkdir -p 111/222/333
touch
功能:创建空文件
语法:
touch 文件路径cat
功能:查看文件内容
语法:
cat 文件路径more
功能:查看文件内容
语法:
more 文件路径- 可以翻页查看,按空格翻页,按
q退出查看
cp
功能:复制文件和文件夹
语法:
cp -r 参数1 参数2-r选项用于文件夹复制- 参数1 被复制的
- 参数2 要复制去的地方
mv
功能:移动文件和文件夹(Windows中的剪切)
语法:
mv 参数1 参数2- 参数1 被移动的
- 参数2 要移动去的地方 如果不存在则改名
- 不需要
-r选项
rm
功能:删除文件和文件夹
语法:
rm [-r -f] 参数1 参数2 ... 参数N- 参数,被删除的文件或文件夹
-r删除文件夹用-f强制删除(不提示,直接删除)
可以写 rm -rf *.txt * 表示通配符,表示 删除全部以.txt结尾的
注意,不要以root用户执行:rm -rf /*
which
功能:查看在Linux系统中所有可执行的命令的文件本地所在。
在Linux系统中执行的命令,本身是一个程序,即一个程序文件。
语法
which 命令find
功能:查找符合条件的文件所在
按文件名
语法:
find 起始路径 -name "被查找的文件名"起始路径如果是
/表示全盘搜索。这样需要管理权限,即root权限。
可以通过执行:
sudo su -切换到root管理员用户去执行,- 或
sudo find ...在find命令前加入sudo临时获得管理员权限
被查找的文件名,支持通配符,如:
find / -name "test*"是在全盘搜索,以test开头的文件find / -name "*test"搜索以test结尾的文件find / -name "*test*"搜索包含test的文件
即, * == 任何 的结果都是True
按文件大小
语法:
find 起始路径 -size +|-n(k|M|G)+表示大于,-表示小于n表示数字k M G表示大小单位,k KB M MB G GB
示例
+10k大于10KB-10M小于10MB+1G大于1G
grep
功能:在指定的内容(输入)中过滤包含关键字的行(仅保留包含关键字的行)
语法:grep [-n] "关键字" 输入内容
-n显示过滤后的内容,在原始输入内容中的行号
示例:
grep hello a.txt在a.txt文件中,过滤hello关键字(仅保留包含hello关键字的行)grep -n hello a.txt在a.txt文件中,过滤hello关键字(仅保留包含hello关键字的行),并显示行号
一般搭配管道符使用,如:
ls /usr/bin | grep gst查看/usr/bin下,带有gst关键字的内容
wc
功能:用来统计输入中的如:字节数量、字符数量、单词数量、行数量
语法:
wc [-c -m -l -w] 输入内容-c统计字节m统计字符-l统计行-w统计单词数
如果不提供选项,则wc本身统计:字节、单词、行数
一般搭配管道符使用
管道符
功能:将管道符的左侧的结果,作为管道符右侧程序的输入。管道符本身是:|
示例
ls -l /usr/bin | wc -l将ls -l /usr/bin的结果作为wc命令的输入,含义就是:- 统计/usr/bin文件夹下的内容数量
管道符可以写多个,如下:
ls -l /usr/bin | grep gst | wc -l- 将
ls -l /usr/bin的结果作为grep gst的输入 - 将
ls -l /usr/bin | grep gst的结果作为wc -l的输入 - 含义:统计
/usr/bin下带有gst关键字的内容的数量
- 将
echo
功能:和Python的print一样,将内容输出到屏幕中。
语法:
echo 内容反引号 `
在Linux中,被`包围的内容,将作为命令去执行。
如:
-
echo pwd将输出pwd字样 -
Terminal window echo `pwd` # 将输出pwd运行的结果,即当前所在工作目录
tail
功能:查看文件尾部或跟踪文件更改
语法:
tail [-f | -num] 文件路径-f表示持续跟踪文件更改,如需退出按ctrl + c退出-num表示查看文件尾部多少行,默认是-10
head
功能:查看文件头部内容
语法:
head [-num] 文件路径-num表示查看头部多少行,默认是-10
重定向符号
含义:将输出的内容重新定向到文件中记录 Linux中有2个:
>将符号左侧内容的结果,重新定向即覆盖写入右侧的文件中>>将符号左侧内容的结果,重新定向即追加写入右侧的文件中
如果右侧提供的文件不存在,则新建
vi/vim编辑器
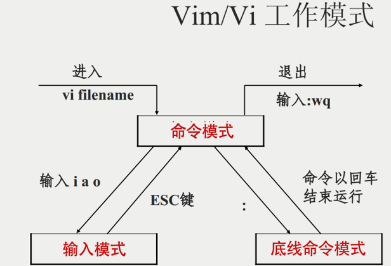
VI编辑器是命令行下面的类似文本编辑器的程序,可以在命令行下完成文件的编辑。
有3个工作模式:
- 命令模式,可以输入各类快捷指令,如删除行、跳转光标等等
- 输入模式,可以正常输入你想要的内容,即开始编辑文件
- 底线命令模式,可以完成对整个文件的控制,如保持、退出等
语法:
vi 文件即可进入vi编辑器界面
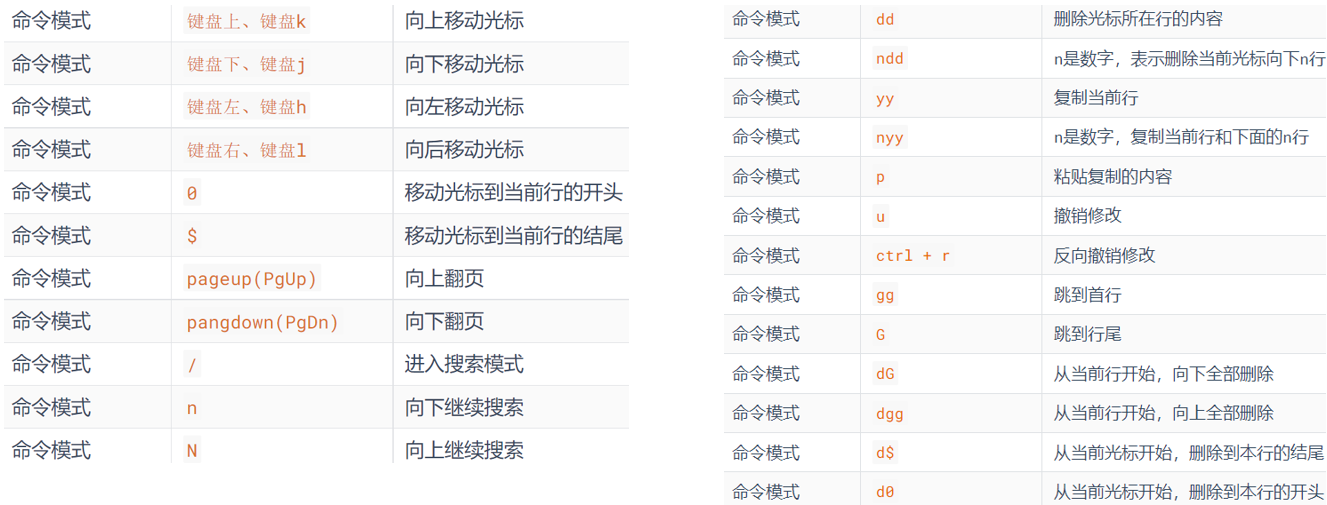
命令模式
当进入vi编辑器,就是命令模式,此模式下可以通过快捷键完成对文件内容的控制,如下:
输入模式
输入模式可以在这个模式下正常编写内容
如果要进入输入模式,必须在命令模式下,通过快捷键进入:
i在当前光标位置,开始编辑o在光标下一行开启新行进行编辑O在光标上一行开启新行进行编辑a在光标右侧开始编辑A在光标所在行的尾部开始编辑
一般就用:
i立刻编辑 或o下一行开始编辑
输入模式要回退到命令模式,按esc 即可
底线命令模式
可以对整个文件做控制。
进入方式为:在命令模式下,输入: 进入底线命令模式。
常见的控制指令有:
w保存更改q退出vi程序!强制(强制退出、强制保存)set nu显示文件行号
组合使用:
wq保存并退出q!忽略更改强制退出wq!强制保存并退出
apt
Linux系统的应用商店,在命令行模式下是:apt 命令
通过这个命令可以联网安装软件
语法:
apt install | remove 程序名 [-y]必须联网
install安装程序remove删除程序-y可选,表示不要提示直接执行
此命令需要root权限,普通用户无权执行。
解决方式:
- 通过
sudo su -切换到root用户执行 - 通过
sudo apt install xxx以root权限执行这个命令- sudo 表示不切换用户,但是此命令以root身份执行
更换apt的网址为国内网站
专业说法:更换APT程序的源
国内有很多公司提供了镜像网站,使用和官方的完全一致,但是网络条件好非常多,常见有:阿里云源、163源、清华源等
步骤:
- 打开清华源官网:
https://mirrors.tuna.tsinghua.edu.cn/help/ubuntu - 选择Ubuntu版本,我们是
20.04,复制下图红框中的文本内容 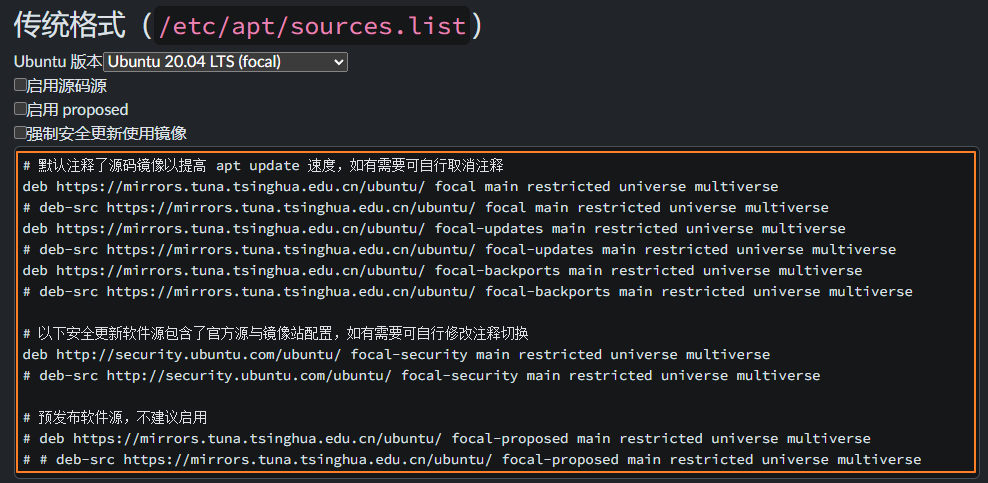
image-20250726150202034 - 备份原有文件,命令是:
sudo cp /etc/apt/sources.list /etc/apt/sources.list.bak - 编辑文件:
sudo vim /etc/apt/sources.list将原有内容清空,粘贴刚刚在网站复制的文本,保存 - 执行
sudo apt update即可 - 后续的
apt命令将从清华大学网站下载内容
后台运行程序
命令:
nohup 你要执行的命令 >> 日志记录文件 2>&1 &比如启动ollama命令:ollama serve 这个会前台运行(终端关闭或ctrl + c关闭后,程序会停止)
我们需要转入后台运行:
nohup ollama serve >> ollama.log 2>&1 &nohup表示进入后台执行,linux自带程序>>将程序运行的日志记录到文件内2>&1 &将标准输出和标准错误都记录到日志文件内并后台执行
WSL 安装
首先先在Windows系统中完成了WSL 功能的开启
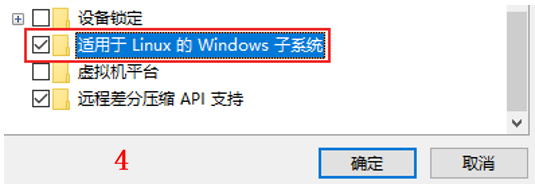
如果这个功能无法开启,请尝试更新Windows系统到最新
通过应用商店图形化安装即可,注意如果网络条件不好,可以用热点,大概消耗500MB流量。
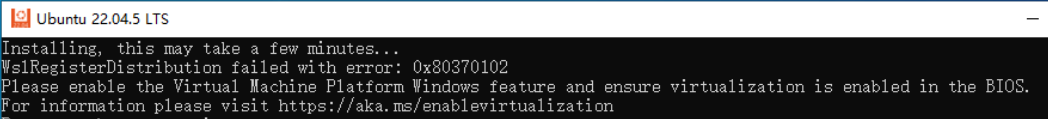
打开提示这个,需要开启虚拟机平台特性
需要确认:
-
应用和功能中勾选虚拟机平台(默认会自动勾选)
image-20250726160311578 某些系统显示是
虚拟机平台 -
确认开启电脑CPU的虚拟化支持(这个正常也是开启的,因为你能用VMware玩虚拟机,这个功能100%是启用的)
首次打开需要等待一会,如下图
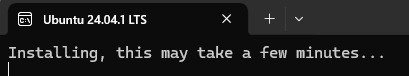
之后可以设置用户名
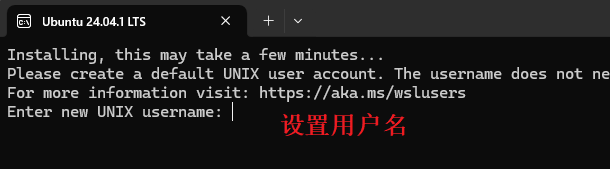
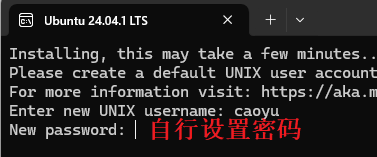
自行设置密码,完成后即可使用。
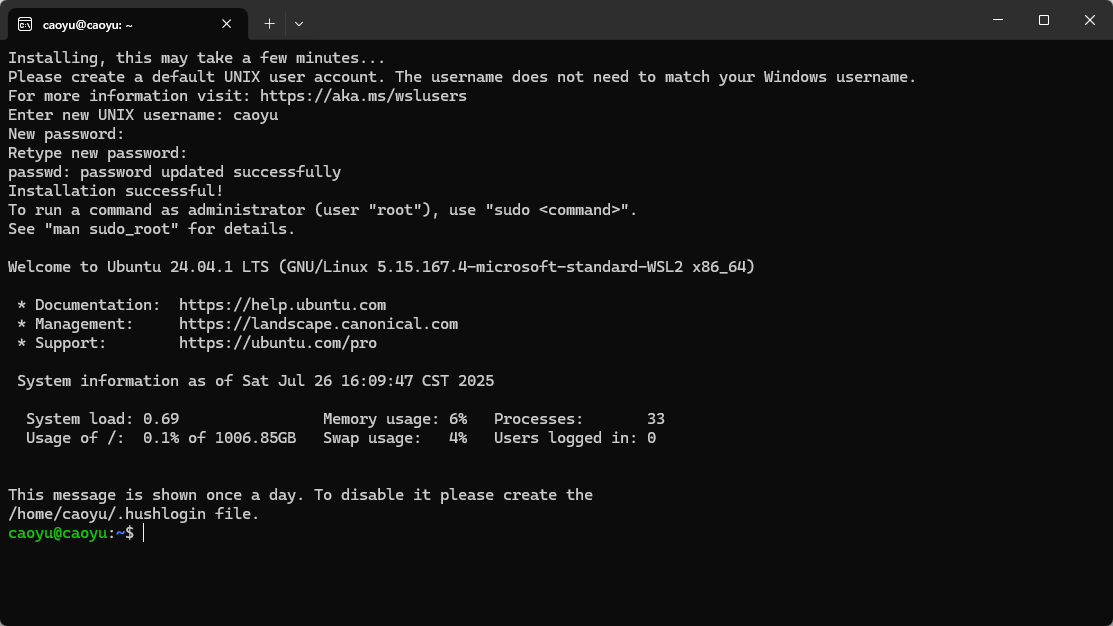
如图一切完事。
通过命令提示符安装WSL Ubuntu发行版
- 打开命令提示符程序,执行
wsl --update即更新到最新版 - 执行命令查看有那些Linux可以装:
wsl --list --online - 执行命令安装:
wsl --install Ubuntu-20.04
AI大模型开发-聊天机器人重点笔记
Ollama 的部署
Ollama介绍
Ollama是一个开源软件,主要作用就是:部署大语言模型。
我们课上主要运行的模型就是:deepseek-r1:1.5b
Windows系统
找到资料中提供的:Ollama-setup.exe 双击打开后,点击Install 即可。
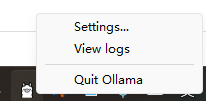
安装好后找到Ollama 软件运行,正常会在右下角出现图表,点击图表选择Settings
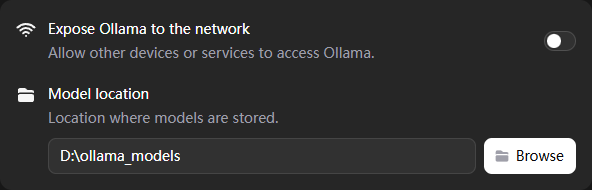
更改模型的安装目录即可。
MacOS系统
略
Linux系统
只需要在命令行下执行一条命令,如下:
curl -fsSL https://ollama.com/install.sh | sh即可自动化完成安装。
开启系统代理
使用自己的:
export http_proxy="http://ip地址:端口"export https_proxy="https://ip地址:端口"使用老师的:
export http_proxy="http://192.168.40.85:7890"export https_proxy="https://192.168.40.85:7890"手动安装Ollama
- 下载安装包:
ollama-linux-amd64.tgz已经在课堂同步的资料文件夹中有 - 打开WSL Ubuntu,通过
cd /mnt找到你的Windows系统中存放这个安装包的地方 - 找到安装包后执行:
cp ollama-linux-amd64.tgz ~将这个安装包从Windows系统复制到Linux系统的用户家目录 - 回到家目录:
cd ~ - 解压Ollama:
sudo tar -xvf ollama-linux-amd64.tgz -C /usr(注意-C是大写的C) - 执行:
ollama serve启动- 或后台启动:
nohup ollama serve >> ollama.log 2>&1 &
- 或后台启动:
后续就可以正常用了。
运行模型
无论什么操作系统,都可以在终端中运行:
ollama run deepseek-r1:1.5b即可运行1.5b参数的deepseek-r1蒸馏模型。
首次运行需要联网下载,大概1.1GB空间。
蒸馏模型
我们运行的模式都是蒸馏模型,即非完整模型。
蒸馏:按照需求进行模型提纯(保留核心网络并进行简化)
我们选择的1.5b参数就是蒸馏后的(提纯和简化),为了方便低性能设备的运行。
完整的DeepSeek模型,简单来说显卡不花个20W基本没啥体验。
模型运行是基于GPU(显卡),因为GPU特点:核多(并行计算能力超强)
- CPU:核心少,比如
i7-13650HX仅仅有20个核心,这些核心每一个都超强,CPU适合通用计算- GPU(显卡):核心超多,动辄上千的流处理器(核心),每个核心都垃圾(对比CPU),GPU适合做并行计算
因为模型的神经网络计算,一般来说是量大,而非计算难度高。
量大的计算,用显卡超爽(核多)
Ollama客户端命令
当安装好Ollama后就可以在命令行中运行ollama命令。
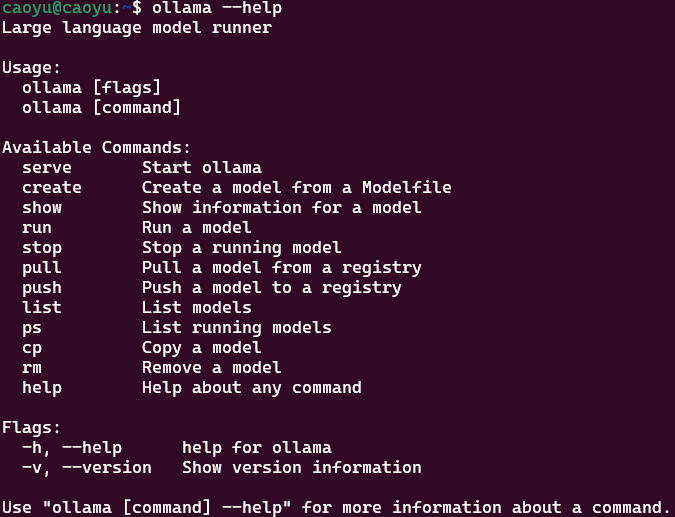
查看帮助
ollama --help可以给出命令执行的帮助信息
启动Ollama
前台启动
ollama serve后台启动(推荐)
nohup ollama serve >> ollama.log 2>&1 &其它控制命令
运行模型:
ollama run 模型名称
ollama run deepseek-r1:7b查看本地有那些模型
ollama list查看当前正在运行的模型
ollama ps
查看模型的详细信息
ollama show 模型名称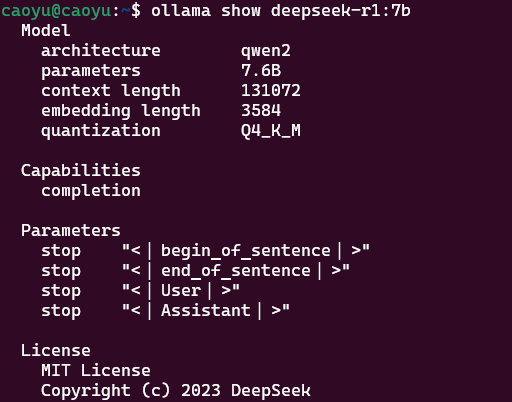
复制一个模型
ollama cp 模型名称 新模型名称
删除模型(慎用)
ollama rm 模型名称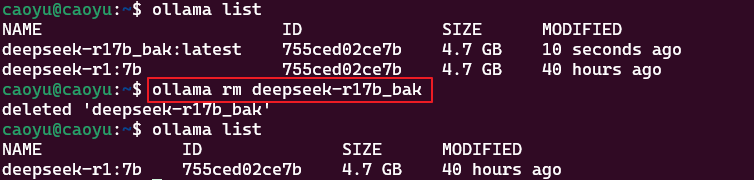
下载模型
ollama pull 模型名称模型名称可以在Ollama官网查询你想要的

此命令,仅下载模型,并不会运行。
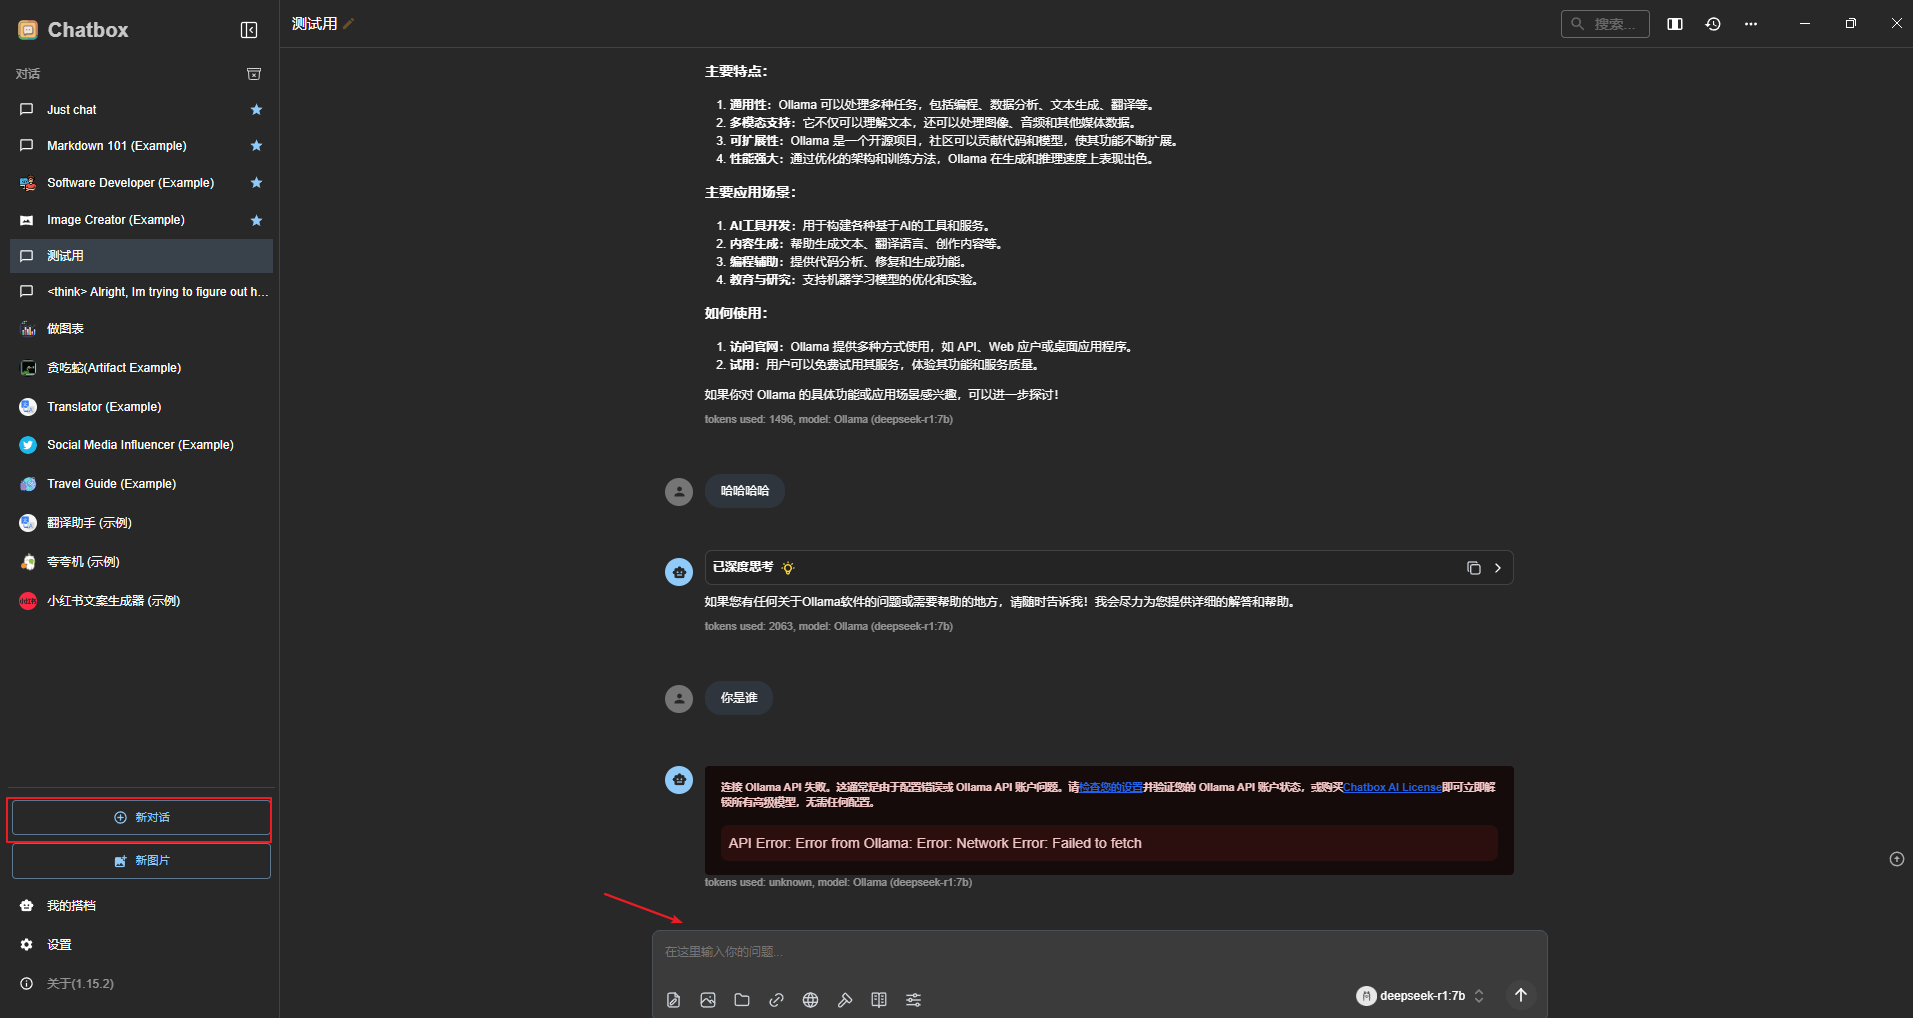
ChatBoxAI工具连接Ollama
我们可以安装ChatboxAI 软件在自己电脑中提供一个对话工具,和我们电脑的Ollama进行连接。
安装:略(找到安装包,一路下一步即可)
前置要求
使用ChatBoxAI软件之前,必须启动你电脑的Ollama
- 启动你Windows版的Ollama
- Windows的Ollama默认无法调用显卡的CUDA计算加速
- 或
WSL Linux版的Ollama都可以用(推荐使用WSL)- Linux下CUDA加速性能更好
配置
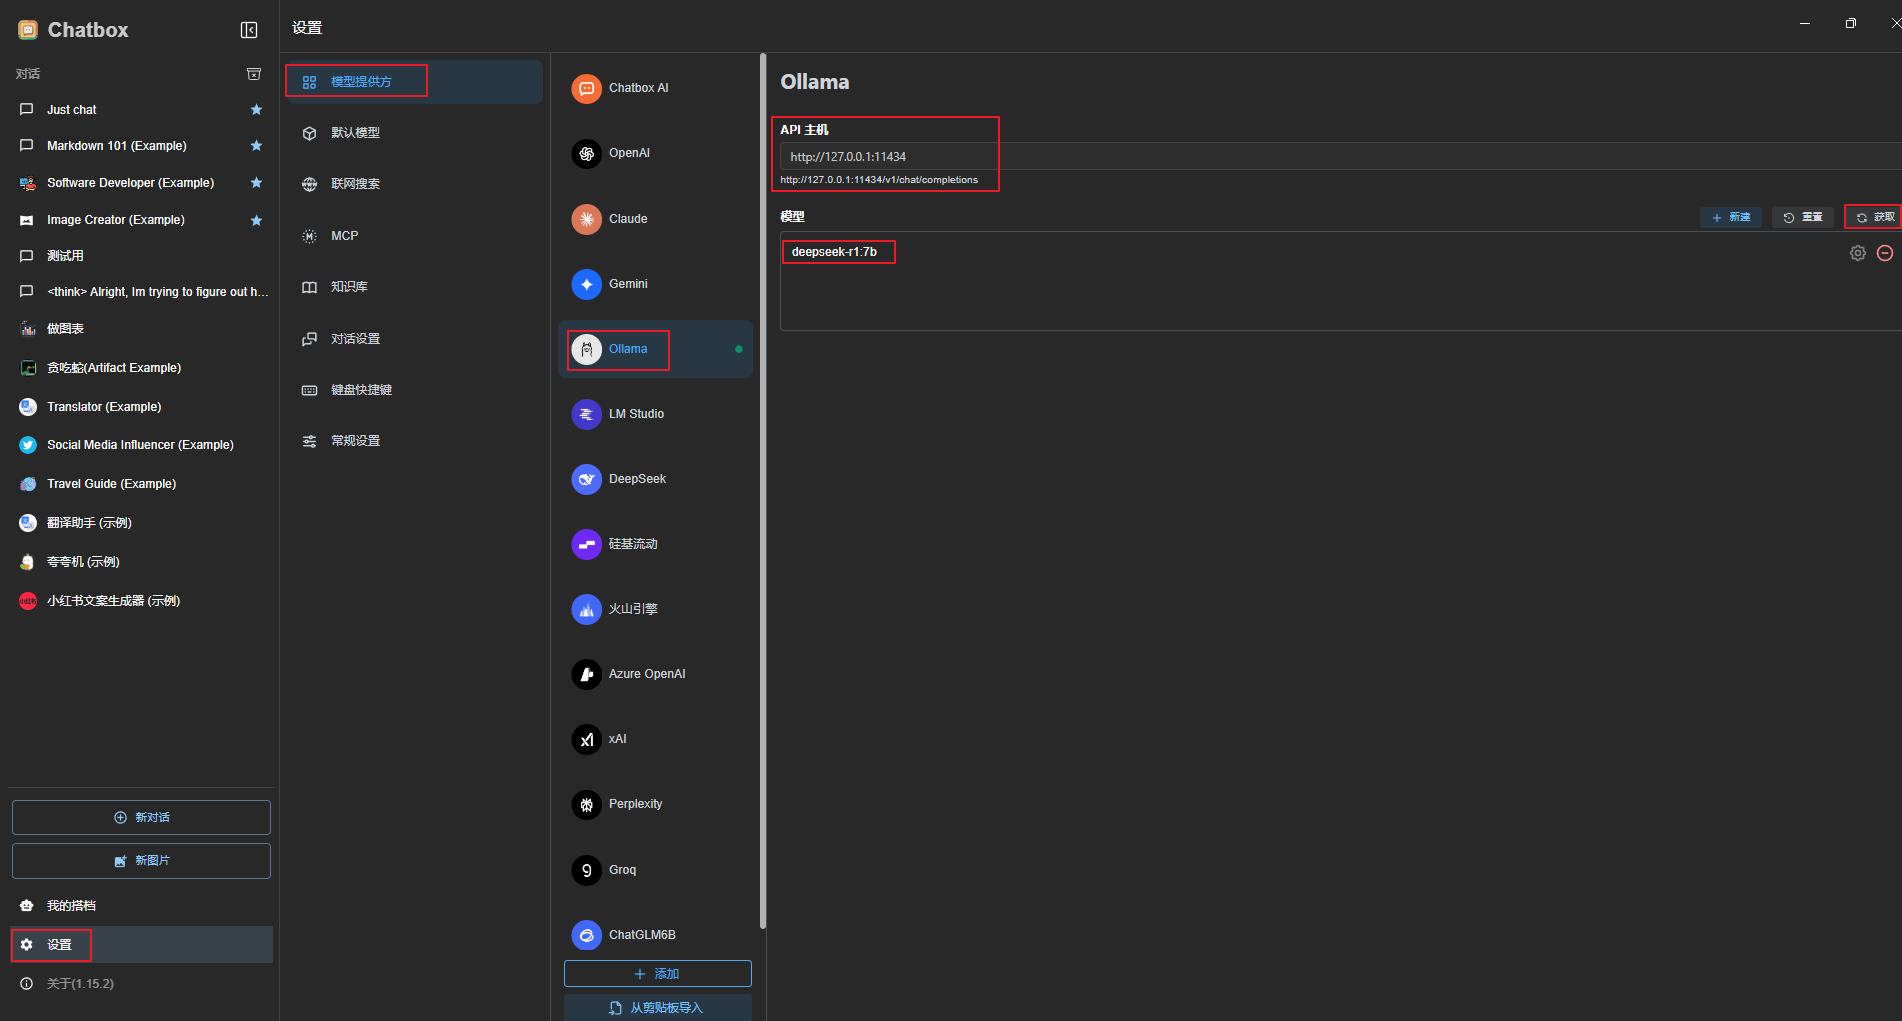
使用
Streamlit
Streamlit是一个Python的第三方库,可以通过很少的代码,开发功能丰富的网页应用。
安装
打开Windows系统的cmd ,运行:
pip install streamlit -i https://pypi.tuna.tsinghua.edu.cn/simple测试Streamlit
打开Windows系统的cmd ,运行:
streamlit hello会自动打开一个网页,可以看到丰富的官方demo 效果。
看完了就可以关了,没啥用。
运行Python代码
使用streamlit编写的Python代码无法直接在PyCharm中执行,需要用cmd执行。
打开系统的命令提示符(CMD)程序,执行:
streamlit run python代码session_state
Streamlit工具编写的网页会定期刷新,等同于每隔一段时间,重新执行整个Python代码。
比如:
import streamlit as st
st.....st.....
d = {}
while True: d[key] = xxx # 每次循环的Key 假设永不重复我们代码写的无限循环,不停的给字典添加信息,但是这个字典能够记录的信息永远只有1个key
因为这段代码被Streamlit执行起来,相当于每隔一段时间都定期执行。
则每一次执行字典d 都会被赋值为空字典。原有记录信息会丢失。
如果想要在网页运行的过程中存储下来信息,可以用Streamlit内置的字典,这个字典将不会丢失内容。
即将代码改为:
import streamlit as st
st.....st.....
while True: st.session_state[key] = xxx # 每次循环的Key 假设永不重复st.session_state 就是一个字典,我们用这个字典,记录的内容就不会丢失。
Python调用Ollama
Python有一个第三方库叫做:ollama
要注意我们现在电脑有2个Ollama:
- WSL Linux中运行的Ollama:
软件程序 - Python的第三方库Ollama
安装Ollama Python库
pip install ollama -i https://pypi.tuna.tsinghua.edu.cn/simple使用Python调用Ollama
"""演示使用Python调用Ollama进行模型对话先确保Ollama已经启动"""
import ollama
# 建立和Ollama的连接(代码和Ollama程序)client = ollama.Client(host="http://127.0.0.1:11434")
# 准备用户的提问prompt = input("请输入你的问题:")
# 封装要提问的格式# [{"role":"user", "content": "提问的内容"}]message = [{"role": "user", "content": prompt}]
# 调用ollama进行回答result = client.chat( model="deepseek-r1:7b", # 模型名 messages=message # 封装好的列表(内含提问信息))
# 只输出回答信息print(result['message']['content'])在云平台使用模型
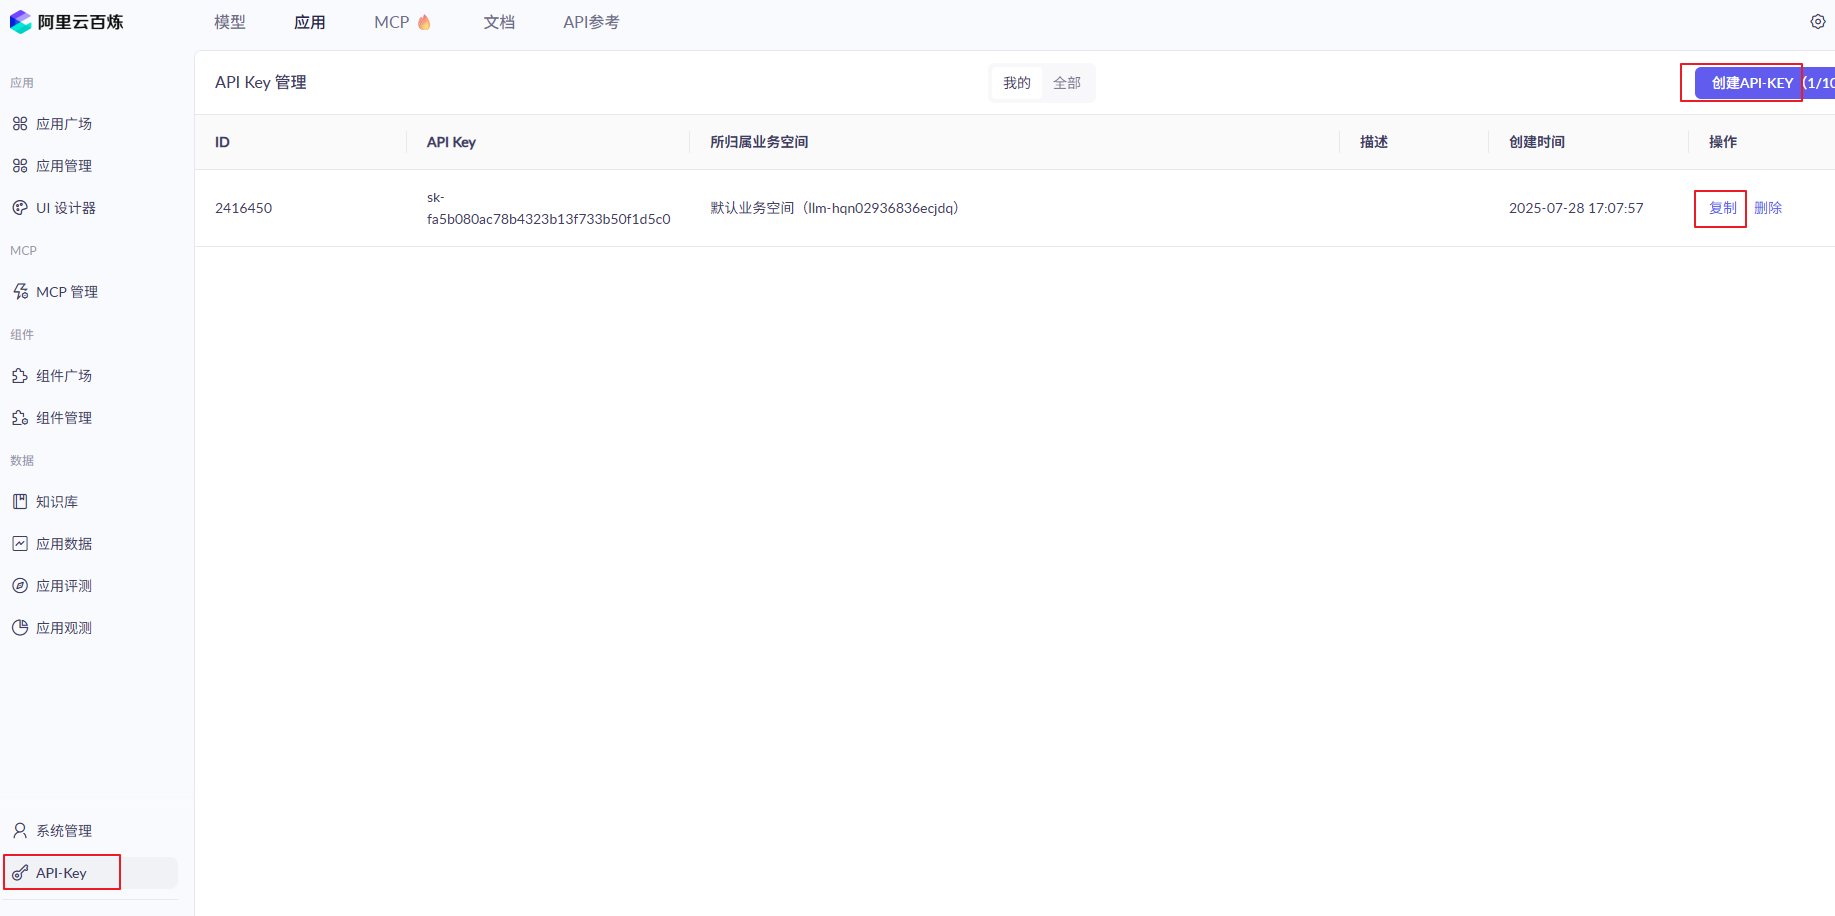
获取云平台API KEY
需要在阿里云百炼平台注册账户,创建应用,创建API KEY
https://bailian.console.aliyun.com
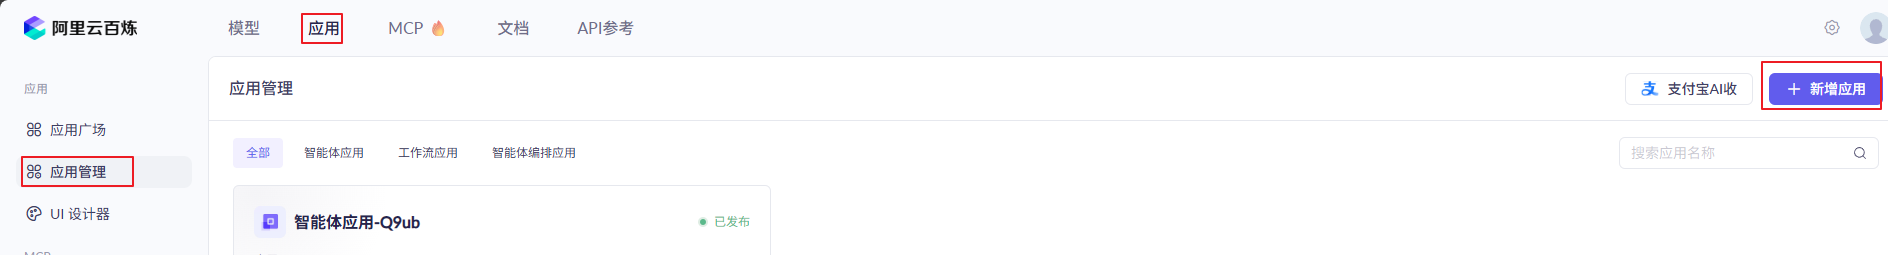
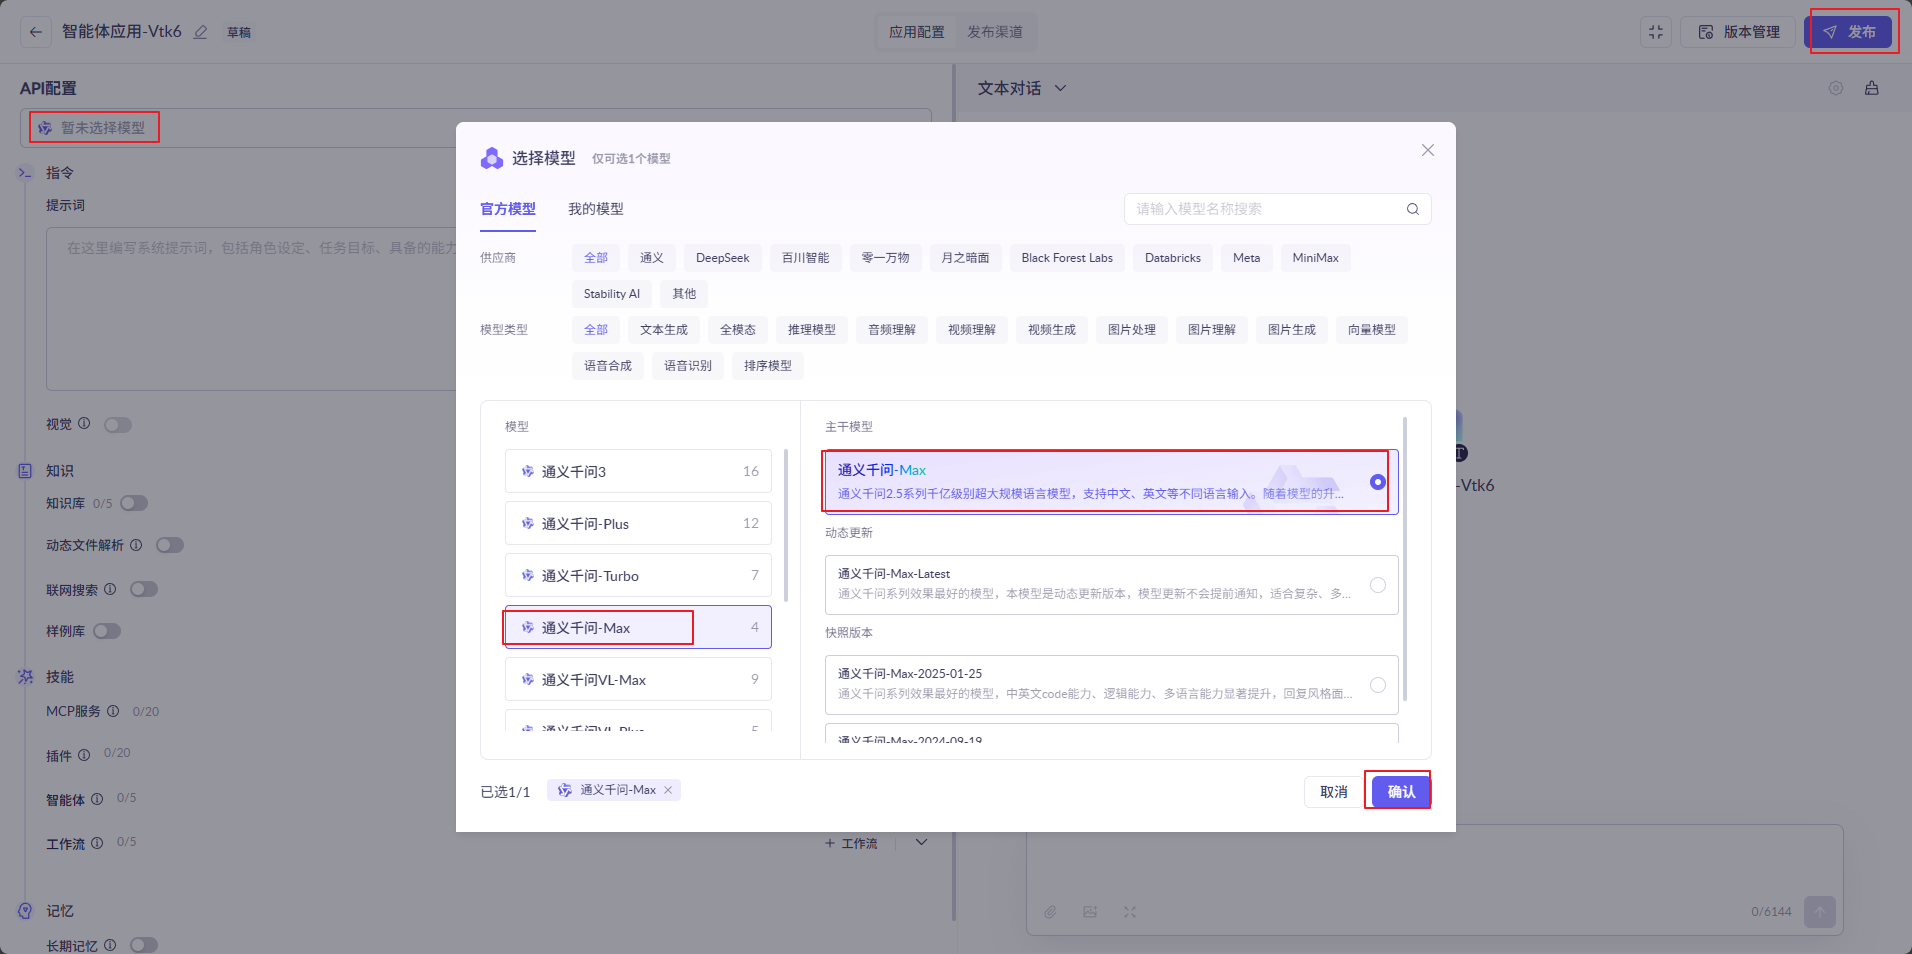
如图点击新增应用,选择智能体应用。
获取API KEY
通过LangChain完成Python代码连接阿里云通义模型
pip安装库
pip install langchain -i https://pypi.tuna.tsinghua.edu.cn/simplepip install langchain-community -i https://pypi.tuna.tsinghua.edu.cn/simplepip install dashscope -i https://pypi.tuna.tsinghua.edu.cn/simple示例
from langchain.chains import ConversationChainfrom langchain.memory import ConversationBufferMemoryfrom langchain_community.llms import Tongyi
memory = ConversationBufferMemory(return_message=True)
def get_response(prompt, api_key): model = Tongyi(model="qwen-max", api_key=api_key) chain = ConversationChain(llm=model, memory=memory)
# 发送请求 response = chain.invoke({"input": prompt})
return response["response"]
if __name__ == '__main__':
print(get_response("请python 1-100的输出", "sk-fa5b080ac78b4323b13f733b50f1d5c0"))抄一遍即可,无需理解代码含义,因为有很多基础知识还未学,目前仅仅体验一下。
Streamlit结合LangChain完成聊天机器人
"""通过Streamlit完成聊天机器人页面开发"""import streamlit as stimport langchain_util as utils
# 添加标题st.title("黑马聊天机器人(阿里云通义千问模型版)")
# 添加分割线st.divider()
# 输出第一条消息 机器人欢迎语if "message" not in st.session_state: st.session_state["message"] = [{"role": "assistant", "content": "你好我是人工智能机器人,有什么可以帮到您!"}] # st.session_state["message"].append({"role": "assistant", "content": "你好我是人工智能机器人,有什么可以帮到您!"})
# list.append({"role": "user", "content": "内容"})# state["message"] = [ {"role": "user", "content": "内容"} , {"role": "user", "content": "内容"}]# 每一个消息的对话分为2部分: 角色,内容# 机器人 角色:assistant 内容:说的话# 人 角色:user 内容:说的话for message in st.session_state["message"]: st.chat_message(message["role"]).write(message["content"])
# 用户输入 在页面下方添加用户输入栏prompt = st.chat_input()
if prompt: # 如果prompt有内容 表示用户提问
# 首先将用户的提问在页面输出 st.chat_message("user").write(prompt)
# 把用户提问这个对话保存到session_state内 st.session_state["message"].append({"role": "user", "content": prompt})
# 调用AI回答 with st.spinner("正在思考中..."): # 转圈圈的加载框 res = utils.get_response(prompt, "sk-fa5b080ac78b4323b13f733b50f1d5c0")
# 将AI回答信息写到屏幕上 st.chat_message("assistant").write(res)
# 将AI回答的消息记录到session_state内 st.session_state["message"].append({"role": "assistant", "content": res})抄一遍即可
课后作业
Day01
字面量
-
写出一个整数字面量
123。 -
写出一个浮点数字面量
3.14。 -
写出一个字符串字面量
"Hello, World!"。 -
(可预习或询问AI,Python布尔类型相关)写出一个布尔字面量
True。 -
(可预习或询问AI,Python布尔类型相关)写出一个布尔字面量
False。
注释 6. 使用单行注释在代码中添加说明:
- 使用多行注释在代码中添加说明:
-
写一段代码,计算两个数的和,并在代码中添加注释说明计算过程。
-
写一段代码,使用注释说明变量的作用。
-
写一段代码,使用多行注释说明代码文件的功能。
变量
11. 定义一个变量 x 并赋值为 10。
```python
```12. 定义一个变量 name 并赋值为 "Alice"。
```python
```13. 定义一个变量 is_valid 并赋值为 True。
```python
```14. 定义一个变量 price 并赋值为 99.99。
```python
```15. 将变量 x 的值更新为 20。
```python
```类型转换(int、float、str 三个类型之间)
16. 将字符串 "123" 转换为整数。
```python
```17. 将整数 456 转换为浮点数。
```python
```18. 将浮点数 78.9 转换为字符串。
```python
```19. 将字符串 "3.14" 转换为浮点数。
```python
```20. 将浮点数 100.0 转换为整数。
```python
```运算符
21. 计算两个数的和:a = 5 + 3。
```python
```22. 计算两个数的差:b = 10 - 2。
```python
```23. 计算两个数的乘积:c = 4 * 6。
```python
```24. 计算两个数的商:d = 20 / 5。
```python
```25. 计算两个数的整除结果:e = 21 // 4。
```python
```26. 计算两个数的余数:f = 21 % 4。
```python
```27. 使用+= 计算变量a*3的结果、使用*= 计算a的3次方
```python
```预习字符串格式化完成
-
2种方法拼接字符串:
name = "Alice",age = 25,输出"Alice is 25 years old."。- 子需求:将25转换为25.0 (基于类型转换实现)然后在拼接到字符内
-
格式化字符串,保留两位小数:
price = 99.9891,输出"The price is $99.99."。- 子需求,将价格格式化为
100
- 子需求,将价格格式化为
-
预习后续内容
Day02 and 自习日
-
1个字符串变量,1个浮点数变量,要求使用三种方式将其拼接在一起(+号拼接、%拼接、f""方式)
-
将浮点数12.356 通过精度控制,输出为:
12.4 -
将整数 12 和浮点数 12.35 对齐输出
-
通过input语句输入一个浮点数,并将其输出为:整体宽度10,小数精度1
-
三个变量name、age、height,通过
input语句输入姓名、年龄、身高并:- 通过
%占位符形式,拼接为:我是xxx、年龄xxx、身高xxx cm - 通过
f"{}"形式,拼接为:我是xxx、年龄xxx、身高xxx cm - 通过
+加法符号的形式,拼接为:我是xxx、年龄xxx、身高xxx cm
- 通过
-
通过input语句输入数字,要求浮点数,范围
0~1之间,如0.8567-
使用”%占位符”形式,输出为
85.67%提示:如果需要在字符串中输出
%本身,可以写:%% -
使用f”{}“形式,输出为
85.7%
-
-
使用 % 占位符和 f-string 格式化字符串,将变量 temperature(温度) 插入到句子中,并显示为两位小数。
-
变量要求input输入
-
要求输出示例为:
当前温度:26.56℃
-
-
使用 % 占位符和 f-string 格式化字符串,将变量 price 和 discount 插入到句子中,并计算折扣后的价格。
- 示例输入:price = 100.0 discount = 0.2 ,要求input输入
- 示例输出:
Original Price: $100.00, Discount: 20.00%, Final Price: $80.00
if判断
-
编写代码,判断一个数是否为正数,如果是正数则打印“正数”,否则打印“非正数”。
-
输入一个年份,判断是否为闰年(能被4整除且不能被100整除,或者能被400整除)。
-
输入一个字符,判断是否为大写字母,如果是则打印“大写字母”,否则打印“不是大写字母”。
-
输入两个数,判断第一个数是否大于第二个数,如果是则打印“第一个数更大”,否则打印“第一个数不大于第二个数”。
-
输入一个成绩(0-100),判断成绩等级:90以上为A,80-89为B,70-79为C,60-69为D,60以下为F。
-
输入一个字符串,判断是否为空字符串,如果是则打印“字符串为空”,否则打印“字符串不为空”。
-
输入一个数字,判断是否为偶数,如果是则打印“偶数”,否则打印“奇数”。
-
输入一个数字,判断是否在1到10之间(包括1和10),如果是则打印“在范围内”,否则打印“不在范围内”。
-
输入一个月份(1-12),判断该月有多少天(考虑平年和闰年)。
-
输入一个用户密码,判断密码长度是否大于8位,如果是则打印“密码强度高”,否则打印“密码强度低”。
if嵌套判断
-
输入一个数字,判断是否为正数,如果是正数,再判断是否大于10,如果是则打印“大于10的正数”,否则打印“小于等于10的正数”;如果不是正数,打印“非正数”。
-
输入一个成绩(0-100),判断成绩等级:如果成绩大于等于90,打印“A”;如果成绩在70到89之间,打印“B”;如果成绩在60到69之间,打印“C”;如果成绩小于60,打印“D”。如果输入的成绩不在0到100之间,打印“无效成绩”。
-
输入一个年份和一个月份,判断该月有多少天(考虑平年和闰年)。
-
输入一个字符,判断是否为字母,如果是字母,再判断是否为大写字母,如果是大写字母,打印“大写字母”,如果是小写字母,打印“小写字母”;如果不是字母,打印“非字母字符”。
-
输入三个数字,判断第一个数字是否大于第二个数字,如果是,再判断第一个数字是否大于第三个数字,如果是,打印“第一个数字最大”,否则打印“第三个数字最大”;如果第一个数字不大于第二个数字,判断第二个数字是否大于第三个数字,如果是,打印“第二个数字最大”,否则打印“第三个数字最大”。
-
输入一个数字,判断是否为正数,如果是正数,再判断是否为偶数,如果是偶数,打印“正偶数”,否则打印“正奇数”;如果不是正数,判断是否为负数,如果是负数,再判断是否为偶数,如果是偶数,打印“负偶数”,否则打印“负奇数”;如果既不是正数也不是负数,打印“零”。
-
输入一个用户年龄和是否购买会员(布尔值),判断用户是否可以享受折扣:如果年龄大于等于60岁或者购买了会员,打印“可以享受折扣”;否则,打印“不可以享受折扣”。
-
输入一个数字,判断是否在1到10之间(包括1和10),如果是,再判断是否为偶数,如果是偶数,打印“在范围内且为偶数”,否则打印“在范围内且为奇数”;如果不在范围内,打印“不在范围内”。
-
输入一个用户输入的密码和确认密码,判断密码是否符合要求(长度大于8位)并且两次输入是否一致:如果密码长度大于8位且两次输入一致,打印“密码设置成功”;如果密码长度不足8位,打印“密码长度不足”;如果两次输入不一致,打印“两次输入不一致”。
-
输入一个用户输入的用户名和密码,判断用户名是否为“admin”且密码是否为“123456”,如果是,打印“登录成功”;如果不是,判断用户名是否为“admin”,如果是,打印“密码错误”;如果不是,打印“用户名错误”。
-
将课堂中的猜数字游戏,改为
给与5次机会,通过if判断嵌套完成 -
将课堂中的猜数字游戏,换一种写法(以尽量少嵌套为主)
-
将课堂中的猜数字游戏,用while循环完成无限次数的猜测,随机数字范围1-100
预习(不强制要求写完)循环语句,尝试完成:
6 个 for 循环练习题
- 使用
for循环打印出从 1 到 10 的所有整数。 - 使用
for循环计算从 1 到 100 的所有整数的和。 - 使用
for循环打印出从 1 到 50 的所有偶数。 - 使用
for循环打印出从 1 到 30 的所有奇数。 - 使用
for循环遍历一个列表[10, 20, 30, 40, 50],并打印出每个元素的平方。 - 使用
for循环完成猜数字游戏,给10次猜测机会,数字范围1 ~ 100
6 个 while 循环练习题
- 使用
while循环打印出从 1 到 10 的所有整数。 - 使用
while循环计算从 1 到 100 的所有整数的和。 - 使用
while循环打印出从 1 到 50 的所有偶数。 - 使用
while循环打印出从 1 到 30 的所有奇数。 - 使用
while循环遍历一个列表[10, 20, 30, 40, 50],并打印出每个元素的平方。 - 使用
while循环完成猜数字游戏,给10次猜测机会,数字范围1 ~ 100
预习(不强制要求写完)函数,尝试完成
6个函数练习题
- 编写一个函数
add_numbers,接收两个参数a和b,返回它们的和。 - 编写一个函数
is_even,接收一个整数参数num,如果该数是偶数则返回True,否则返回False。 - 编写一个函数
greet,接收一个字符串参数name,返回一个欢迎消息,例如"Hello, Alice!"。 - 编写一个函数
factorial,接收一个整数参数n,返回该数的阶乘(n!)。 - 编写一个函数
max_of_three,接收三个整数参数a、b和c,返回其中的最大值。 - 尝试完成课件中的:黑马ATM案例
Day03
-
使用for循环打印1-100之间的奇数
-
使用while循环打印1-100之间的偶数
-
使用for循环生成如下图形
-
使用while循环生成如上图形
-
找出所有三位数中的水仙花数。水仙花数是一个三位数,它的每一位数字的立方和等于它本身。例如,153是一个水仙花数,因为 1^3 + 5^3 + 3^3 = 153。使用for或while解决
-
使用 for 循环或 while 循环计算1到100的总和,并打印结果。
-
使用while或for循环生成如下图形:
-
进阶,使用input输入任意
奇数,然后输出对应的图形,如: -
将上一题的需求封装为函数,每次调用函数传入一个奇数数值,然后函数会打印出来对应的图形。
-
实现一个函数,接收3个数字的传入,通过print语句输出最大的那个数字
-
实现一个函数,接收3个数字的传入,通过return返回最小的那个数字
-
总结目前的知识点以思维导图的形式
要求,所有函数给出规范注释
练习:
- 创建一个列表存储5个学生姓名
- 通过print语句打印第三个学生的姓名(正向和反向下标都用一次)
- 创建一个双层嵌套列表(二维矩阵),取出任意一个元素
Day04
列表(List)
-
创建一个包含5个整数的列表,并打印出来。
-
计算列表的长度。
-
从列表中提取第2到第4个元素。
-
向列表中追加一个元素。
-
对列表进行排序。
-
删除列表中的第一个元素。
-
合并两个列表。
-
找出列表中的最大值和最小值。
-
反转列表的顺序。
元组(Tuple) 11. 创建一个包含5个整数的元组,并打印出来。
-
计算元组的长度。
-
从元组中提取第2到第4个元素。
-
尝试修改元组中的一个元素(观察是否报错)。
-
合并两个元组。
-
找出元组中的最大值和最小值。
-
创建一个嵌套元组并访问其中的元素。
-
使用
count()方法统计元组中某个元素的出现次数。 -
使用
index()方法查找元组中某个元素的索引。
集合(Set) 21. 创建一个包含5个整数的集合,并打印出来。
-
计算集合的长度。
-
向集合中添加一个元素。
-
从集合中移除一个元素。
-
合并两个集合。
-
找出两个集合的交集。
-
找出两个集合的并集。
-
找出两个集合的差集。
-
检查一个元素是否在集合中。
-
清空集合。
字符串(String) 31. 创建一个字符串并打印出来。
-
计算字符串的长度。
-
将字符串转换为大写。
-
将字符串转换为小写。
-
检查字符串是否以某个字符开头。
-
检查字符串是否以某个字符结尾。
-
替换字符串中的某个字符。
-
分割字符串为列表。
-
检查字符串是否只包含字母。
字典(Dictionary) 41. 创建一个包含3个键值对的字典,并打印出来。 42. 计算字典的长度。 43. 访问字典中的某个键对应的值。 44. 向字典中添加一个键值对。 45. 从字典中移除一个键值对。 46. 遍历字典的所有键。 47. 遍历字典的所有值。 48. 遍历字典的所有键值对。
列表(List)
-
列表元素查找
编写一个程序,使用
max()函数找出列表中的最大值。 -
列表元素移除
编写一个程序,使用
list()函数将元组转换为列表,并使用remove()方法移除列表中的特定元素。 -
列表长度计算
编写一个程序,使用
len()函数计算列表中元素的数量。
元组(Tuple) 4. 元组元素访问
编写一个程序,使用索引访问元组中的元素,并使用min()函数找出元组中的最小值。
-
元组元素转换
编写一个程序,将列表转换为元组,并使用
str()函数将元组转换为字符串。
集合(Set) 6. 集合元素去重
编写一个程序,使用set()函数将列表转换为集合,去除列表中的重复元素。
-
集合元素排序
编写一个程序,使用
sorted()函数对集合中的元素进行排序,并设置reverse=True以逆序排列。
字符串(String) 8. 字符串长度计算
编写一个程序,使用len()函数计算字符串的长度。
-
字符串转换
编写一个程序,使用
str()函数将数字转换为字符串,并使用sorted()函数对字符串中的字符进行排序。
字典(Dictionary) 10. 字典元素访问
编写一个程序,创建一个字典,并使用`for`循环遍历字典中的所有键值对。- 编写一个函数(名字func),接收2个数字和一个函数
- 要求用接收的函数,对接收的2个数字 进行计算,计算逻辑任意 要求使用lambda
Day05
-
编写一个程序,可以生成10000条数据到
data.txt文件中,数据格式要求:-
循环10000次,每次写入1条数据
-
每一条数据都是随机生成的零散数据拼接成如下的格式
要求:
-
id不可重复
-
姓名随机从一个姓名list中随机抽取,可以重复
-
年龄随机10~35的范围
-
身高随机160~190 CM的范围
-
体重随机70~120 KG的范围
-
性别,随机男或女
-
城市随机,可以重复
-
-
读取
data.txt统计如下需求:- 年龄3个档,每个档的人数
- 10~18岁档
- 18~26档
- 26~35档
- 身高大于等于170和小于170各自的人数
- 计算体重BMI(自行问AI)指数超过28和小于等于28的人数
- 提示,这些统计都需要用字典(key就是分组,value是数据)
- 年龄3个档,每个档的人数
-
编写Python目前学到的全部语法的思维导图
Day06 (Linux)
-
请说出
/在Linux系统中作为路径符的两种作用- 根目录(root),在Linux有有且仅有一个根目录,称之为
/ - 路径层次分隔符,如
abc/edf含义:abc文件夹中有edf
- 根目录(root),在Linux有有且仅有一个根目录,称之为
-
请写出路径:在根目录下有home文件夹,home文件夹内有itheima文件夹,itheima文件夹里面有test文件夹,test文件夹内有hello.txt文件,请写出hello.txt文件的绝对路径
/home/itheima/test/hello.txt- 如果当前工作目录在
/home,请基于此,写出hello.txt文件的相对路径itheima/test/hello.txt./itheima/test/hello.txt
-
请写出如下符号在路径中的作用:
~:当前登陆用户的HOME目录.当前所在目录..上一级目录 (向上)-上一次的目录(回退)
-
请根据描述写出命令:
-
以平铺形式,查看根目录有啥
ls / -
以列表形式,并查看隐藏内容,看看用户的HOME目录有什么(要求必须使用
~符号)ls -la ~ -
以列表形式,并查看隐藏内容,并以更友好的形式展示文件大小,查看根目录内有什么
ls -lah /
-
-
查看当前工作目录的命令是:
pwd -
cd -代表含义是:返回上一次去过的文件夹 -
相对路径是以
当前所在工作目录为基准的路径表达形式(填空) -
绝对路径是以
根目录为基准的路径表达形式(填空)-
请举例说明绝对路径和相对路径的区别(不可以用课上说的 中国->广东->深圳 这个案例)
绝对:我要喝 饮料->碳酸饮料->可口可乐
相对:我要喝 可口可乐
-
-
切换工作目录到,上一级目录内的test文件夹,请写出命令:
cd ../test -
切换工作目录到上一级的上一级的test文件夹,请写出命令:
cd ../../test -
切换到当前目录内的Desktop文件夹,请写出命令(必须使用
.符号):cd ./Desktop -
假设当前目录在
/usr/local,请在用户家目录创建文件夹666,要求必须使用..符号mkdir ../../home/用户名/666 -
请在用户的家目录创建:
111/222/333连续层级目录mkdir -p ~/111/222/333 -
在用户的家目录创建1.txt文件
touch ~/1.txt -
通过图形化,修改1.txt,随意填入内容
-
通过cat命令和more命令查看1.txt的内容
cat ~/1.txtmore /home/用户名/1.txt
预习:
- cp、mv、rm
- which、find
- 管道符
- 重定向符
- vi编辑器部分
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!